Il 15 settembre 2026 è uscito Jev TypeSafe AI, e la cosa curiosa è che non è un chatbot. Non scrive risposte, non genera codice, non riassume documenti.
Gli passi uno stato (un ticket, un ordine, una mail) e delle domande con risposte già definite. Lui restituisce decisioni tipizzate con una probabilità accanto.
Detta così sembra una cosa piccola. In realtà tocca un punto dolente per chiunque integri l'AI in un gestionale o in un flusso di automazione: stiamo pagando un modello da chat, lento e costoso, per rispondere a domande tipo "questo ticket è urgente?" o "questa mail è una fattura?".
Vediamo cos'è Jev, come si chiama dal codice, quanto costa davvero e dove ha senso metterlo. Ti segnalo sempre quando un numero è una dichiarazione dell'azienda non ancora verificata da terzi.
Cos'è Jev e chi c'è dietro TypeSafe AI
TypeSafe AI è un laboratorio di San Francisco uscito dalla fase stealth il 15 settembre 2026, con 40 milioni di dollari di seed guidati da DCVC.
Il fondatore è Diogo Almeida, ex ricercatore OpenAI che ha contribuito ai metodi (RLHF, InstructGPT) da cui è nato ChatGPT.
Il suo ragionamento, scritto nel post di lancio ufficiale, è semplice: i modelli chattano benissimo da anni, ma l'automazione vera nelle aziende non è esplosa. Secondo lui, un modello addestrato per piacere alle persone non è il componente giusto dentro un software che deve decidere in modo affidabile.
Jev TypeSafe è il primo modello pubblico di questa nuova famiglia, disponibile in early access. Il nome viene da William Stanley Jevons, l'economista del paradosso: quando una risorsa diventa più efficiente, se ne consuma di più.
L'idea è che, abbattendo il costo di una "decisione intelligente", diventino convenienti automazioni che oggi nessuno fa.
Perché si chiama "System One model"
La categoria si ispira a Pensieri lenti e veloci di Daniel Kahneman. Il Sistema 1 è il pensiero rapido e intuitivo, il Sistema 2 quello lento e deliberato.
Gli LLM con ragionamento sono Sistema 2. Jev invece è pensato per il Sistema 1: giudizi veloci su domande chiuse, del tipo "in quale reparto va questo messaggio?".
La tesi è che dentro il software la maggior parte delle decisioni sia di questo tipo. E che finora le abbiamo affidate a modelli da Sistema 2, pagandole care.
Come funziona Jev TypeSafe: stato dentro, decisioni tipizzate fuori
La differenza architetturale è netta. Un LLM genera un token alla volta, ognuno condizionato dal precedente.
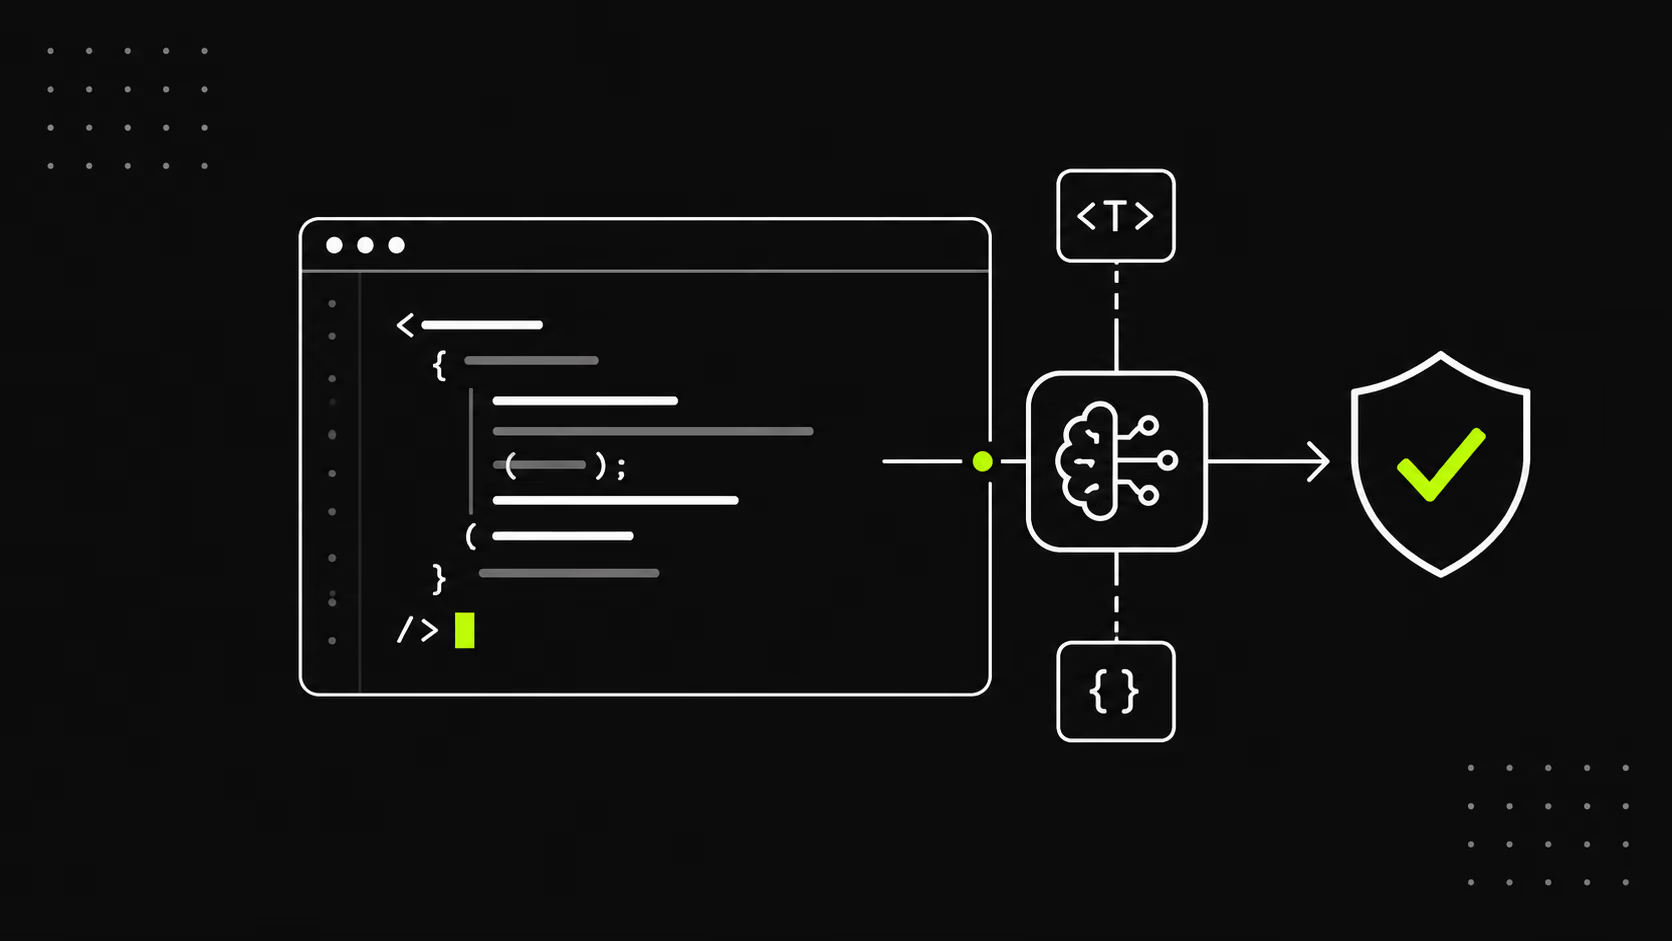
Jev TypeSafe non genera testo: valuta tutte le domande in parallelo, in un solo passaggio, e restituisce valori strutturati con probabilità e punteggio di confidenza.
TypeSafe lo descrive come una "chiamata di funzione con intelligenza di frontiera". Non c'è una stringa da parsare, non c'è un JSON da validare, non c'è il rischio che il modello ti restituisca una frase invece di un valore.
Le tre primitive: Choice, Score e Noul
Tutta l'API si basa su tre tipi di domanda. Non è un limite da aggirare, è il design:
- Choice: sceglie un'opzione da un insieme (fino a 255). Restituisce la scelta, la probabilità di ogni opzione e la confidenza. Aggiungi sempre un'opzione "altro", così il modello può dire che nulla corrisponde.
- Score: colloca la risposta su una scala da 2 a 10 livelli descritti a parole (es. "calmo", "infastidito", "molto arrabbiato"). Il punteggio può cadere tra due livelli, per esempio 1,035.
- Noul: un sì/no espresso come probabilità da 0 a 1. Niente campo confidenza, perché il numero stesso è la fiducia del modello.
RLCD: l'addestramento sulle probabilità calibrate
Gli LLM classici sono ottimizzati con RLHF (preferenze umane) o RLVR (risposte verificabili). Jev usa un metodo nuovo chiamato Reinforcement Learning for Calibrated Decisions (RLCD).
L'obiettivo è che le probabilità siano "oneste": una confidenza più alta deve corrispondere davvero a una precisione più alta.
Questo è il punto che per me cambia l'architettura. Se un modello fa bene un compito il 95% delle volte ma non ti dice quando è nel 5%, non puoi automatizzarlo. Se invece te lo dice, il codice agisce quando la confidenza è alta e passa la mano a un umano quando è bassa.
Velocità e prezzi di Jev TypeSafe: i numeri dichiarati
Ecco il confronto che TypeSafe pubblica nel post di lancio:
- Tempo di risposta: da 70 a 500 millisecondi end-to-end, contro i 3-329 secondi dei modelli di frontiera citati da TypeSafe.
- Costo input: 0,042 $ per milione di token (42 $ per miliardo), contro 0,20-10 $ per milione dei LLM.
- Costo output: gratuito. Negli LLM l'output costa tipicamente circa 5 volte l'input.
- Errori di formato: 0% per costruzione, perché lo schema delle risposte è definito prima.
Sul benchmark interno di quattro workflow, Jev ottiene il 67,8%. È praticamente alla pari con GPT-5.6 Terra (67,9%) e Claude Sonnet 5 (67,8%), dietro Opus 5 (73,1%). La differenza è nel costo: circa un duecentesimo per singolo caso.
Se ti interessa il tema dei costi per token, ne ho parlato nel confronto su DeepSeek V4.1 Flash e nella guida ai prezzi di Gemini 3.8 Flash. Jev gioca un campionato diverso, perché non compete sulla generazione.
Tre cautele prima di fidarti dei numeri
- Il benchmark non misura l'accuratezza assoluta. TypeSafe confronta le risposte con la media di GPT-6 Astra e Claude Fable 5.1: misura l'accordo con due modelli di frontiera, e l'azienda ammette il bias.
- È autovalutato. Workflow, harness ed esecuzione sono di TypeSafe. Al momento non esiste una riproduzione indipendente.
- "Non allucina" è più stretto di quanto sembri. Jev non può restituire un valore fuori dallo schema, ma può scegliere il valore valido sbagliato. E TypeSafe ammette di non poter dimostrare che il prezzo non sia sovvenzionato.
Come si usa Jev: setup e primo esempio
L'accesso è in early access con lista d'attesa su typesafe.ai. La chiave si genera dalla console di TypeSafe.
Jev TypeSafe è disponibile anche tramite Vercel AI Gateway, compare nel catalogo modelli di Cloudflare ed esiste un'integrazione LangChain (langchain-typesafe). Gli SDK ufficiali sono due:
- TypeScript/JavaScript (Node 20+):
npm install @typesafe-ai/sdk - Python (3.10+):
pip install typesafe-sdk
Entrambi leggono la variabile d'ambiente TYPESAFE_API_KEY e usano di default il modello jev-latest. Se preferisci chiamarlo a mano, c'è un unico endpoint REST: POST https://api.typesafe.ai/v1/systemone. Trovi i dettagli nella documentazione ufficiale.
Esempio in TypeScript: triage delle richieste di assistenza
Prendiamo un caso che vedo spesso nelle PMI: una casella di assistenza dove arrivano richieste miste. Vogliamo sapere di cosa si tratta e se è urgente.
import { choice, noul, TypeSafeClient } from "@typesafe-ai/sdk";

const client = new TypeSafeClient();

const response = await client.systemOne({
  state: {
    document: "Buongiorno, mi avete addebitato due volte l'ordine 1042. Rimborsate subito per favore.",
  },
  questions: {
    category: choice("Di cosa tratta la richiesta?", {
      billing: "Pagamenti, addebiti, rimborsi",
      technical: "Errori o problemi tecnici",
      other: "Tutto il resto",
    }),
    urgent: noul("Il messaggio comunica urgenza"),
  },
});

console.log(response.answers.category.choice); // tipi inferiti dalle domande
console.log(response.answers.urgent.noul);      // probabilità da 0 a 1
Nota due cose. I tipi delle risposte vengono inferiti dalle domande, quindi l'editor ti avvisa se leggi un campo che non esiste.
E aggiungere domande costa token in ingresso ma quasi zero tempo, perché vengono valutate in parallelo.
Lo stato può essere testo, oggetto o conversazione
Lo state accetta una stringa, un oggetto JSON o un array di messaggi. Con più contesti (messaggio, dati dell'ordine, policy di rimborso) conviene l'oggetto con campi nominati.
Solo testo: niente immagini, audio o video. I limiti sono 64k token per stato più tutte le domande, e 32k per stato più la domanda più lunga.
Quattro pattern che conviene copiare
1. Chiedi tutto subito (fan-out speculativo)
Con un LLM l'istinto è fare una chiamata economica e poi una seconda solo se serve. Con Jev è il contrario: fai tutte le domande in una volta e lascia decidere al codice cosa usare.
Nel cookbook di TypeSafe, raggruppare 13 domande in una chiamata è risultato 12 volte più economico e 10 volte più veloce rispetto a farle una per una, con risposte identiche.
2. Una soglia di confidenza per ogni azione
Non una soglia unica per tutto il sistema: una per azione, proporzionata al costo dell'errore. Mostrare un saldo? Soglia bassa. Approvare un bonifico? Soglia alta, altrimenti chiedi conferma. Confidenza sotto 0,5? Passa a un umano.
3. Punteggi composti con pesi tuoi
Invece di chiedere "quanto è buono questo candidato?", scomponi in dimensioni indipendenti (esperienza tecnica, leadership, progettazione) e combina i punteggi con pesi scelti da te.
Cambiare i pesi diventa una modifica di codice, testabile con un A/B, non una riscrittura del prompt.
4. La cascata: Jev decide chi merita un LLM
Jev non sostituisce Opus 5 o GPT-5.6: decide quali richieste meritano un modello grande. Stato di un ordine? Basta una query al database. Domanda su un prodotto? LLM specializzato. Reclamo complesso? Operatore umano.
Su un milione di ticket, la stima riportata nella guida pratica su DEV Community passa da circa 30.400 $ a circa 6.480 $.
Dove ha senso Jev TypeSafe per una PMI italiana (e dove no)
Pensando ai progetti che seguo per aziende del Cilento e della Campania, i casi giusti sono quelli ad alto volume e con risposte note in anticipo:
- Triage della posta: fattura, preventivo, reclamo, spam, richiesta commerciale.
- Instradamento dei lead dal form del sito al commerciale giusto, con un punteggio di priorità.
- Moderazione di recensioni e commenti prima della pubblicazione.
- Filtro di rilevanza nei RAG: scarti i passaggi inutili prima di mandarli a un modello costoso. Prima leggi la mia guida su quando serve davvero un database vettoriale.
- Nodi decisionali in n8n o in un gestionale: gli "if" troppo sfumati per essere scritti a mano.
Dove invece non va usato: generare testi, fare conti, confrontare date, spiegare una decisione a un revisore, rispondere a domande aperte. Per questo resta un LLM classico, o meglio ancora codice deterministico.
I limiti dichiarati da TypeSafe
TypeSafe pubblica una pagina onesta sui punti deboli di jev-1.13:
- Legge alla lettera: risponde alla domanda che hai scritto, non a quella che intendevi.
- Non sa contare in modo affidabile. Conta nel codice e fai un Noul per elemento.
- Le date per lui sono testo: estrai con Jev, calcola nel codice.
- Soffre di context rot: più riempi lo stato di roba inutile, più scende la precisione.
- Non tratta lo stato come ostile: un testo scritto apposta per "convincerlo" può spostare la classificazione. Con contenuti degli utenti, il rischio lo gestisci tu.
Privacy, GDPR e responsabilità: cosa valutare
Questo è l'aspetto che le guide in inglese ignorano e che per un cliente italiano pesa. TypeSafe scrive che il servizio oggi si trova sulla West Coast americana.
Prima di mandargli dati personali dei tuoi clienti devi verificare trasferimento extra UE, DPA e basi giuridiche, come faresti con qualsiasi fornitore americano.
C'è poi la tracciabilità. Con il decreto sull'intelligenza artificiale in vigore dal 30 settembre i log delle decisioni automatiche contano anche in caso di contenzioso.
Due buone pratiche: fissa la versione del modello (jev-1.13.0 invece di jev-latest, che cambia a ogni rilascio) e salva nel log il campo model della risposta con probabilità e confidenza.
Infine la chiave API: trattala come denaro. Come racconto nell'articolo sul threat report di Anthropic sulle API key rubate, oggi sono un bersaglio preferito. Con limiti di 250.000 token al secondo e 1.200 richieste al minuto, una chiave esposta brucia credito in fretta.
Leggi anche
- Pi coding agent: cos'è, come si usa e quando sceglierlo
- DeepSeek V4.1 Flash: benchmark, prezzi e cosa cambia davvero
- Database vettoriale: quale scegliere e quando evitarlo
- Claude Code best practices: cosa insegnano 400.000 sessioni
Conclusione: Jev TypeSafe non è un LLM più economico
Il modo giusto di guardare a Jev TypeSafe AI non è "un ChatGPT che costa meno". È una primitiva diversa: una funzione che ragiona, restituisce un tipo e ti dice quanto fidarti del risultato.
Messa al posto giusto, elimina il codice che oggi scriviamo solo per sopravvivere all'output testuale degli LLM: parsing, validazione, retry.
È ancora early access e i numeri vanno verificati sul tuo traffico reale. Ma per i flussi ad alto volume con risposte chiuse, vale la pena provare Jev TypeSafe in parallelo al sistema attuale e confrontare i risultati.
Se vuoi capire se nel tuo gestionale o nelle tue automazioni c'è spazio per un modello così, scrivimi e ne parliamo. Puoi anche dare un'occhiata ai miei servizi di sviluppo web app e integrazioni AI.