Aggiornamento settembre 2026: cosa cambia con Fable 5.1
Dal 1 settembre il modello di punta di Anthropic è Claude Fable 5.1 (
claude-fable-5-1). La logica di questo confronto resta valida, ma quattro cose cambiano:
- Prezzo: listino invariato a 10 e 50 dollari per milione di token, ma le letture in cache scendono a 0,25 dollari, il 75% in meno. Anthropic stima un risparmio di circa il 25% su un carico tipico e fino al 45% su quelli molto agentici rispetto a Fable 5.
- Distacco da Opus 5: sui benchmark pubblicati da Anthropic, Fable 5.1 è davanti a Opus 5 su tutte le prove, per esempio 55,8% contro 52,3% su Terminal-Bench 4.0 e 73,4% contro 70,0% su CursorBench 3.2.0. Su Terminal-Bench 4.0 Fable 5 si fermava al 42,0%, sotto Opus 5.
- Meno risposte da Opus: le tutele intervengono circa il 60% in meno sulla cybersecurity in Claude Code e l'85% in meno sulle richieste benigne di biologia. Penetration testing, generazione di exploit e scansione di binari restano instradati sui modelli Opus.
- Effort regolabile: alto di default in Claude Code, medio in Claude.ai. A effort basso o medio Anthropic dichiara risultati simili o migliori di Fable 5, a costo inferiore.
Cosa non cambia: Opus 5 costa la metà ed è ancora il default sensato per il lavoro corto, mentre Fable si giustifica sui compiti lunghi. Prezzi, benchmark e la modifica alle API sono in Claude Fable 5.1: cosa cambia e quanto costa; se stai confrontando Fable con OpenAI, leggi GPT-6 Astra vs Claude Fable 5.1.
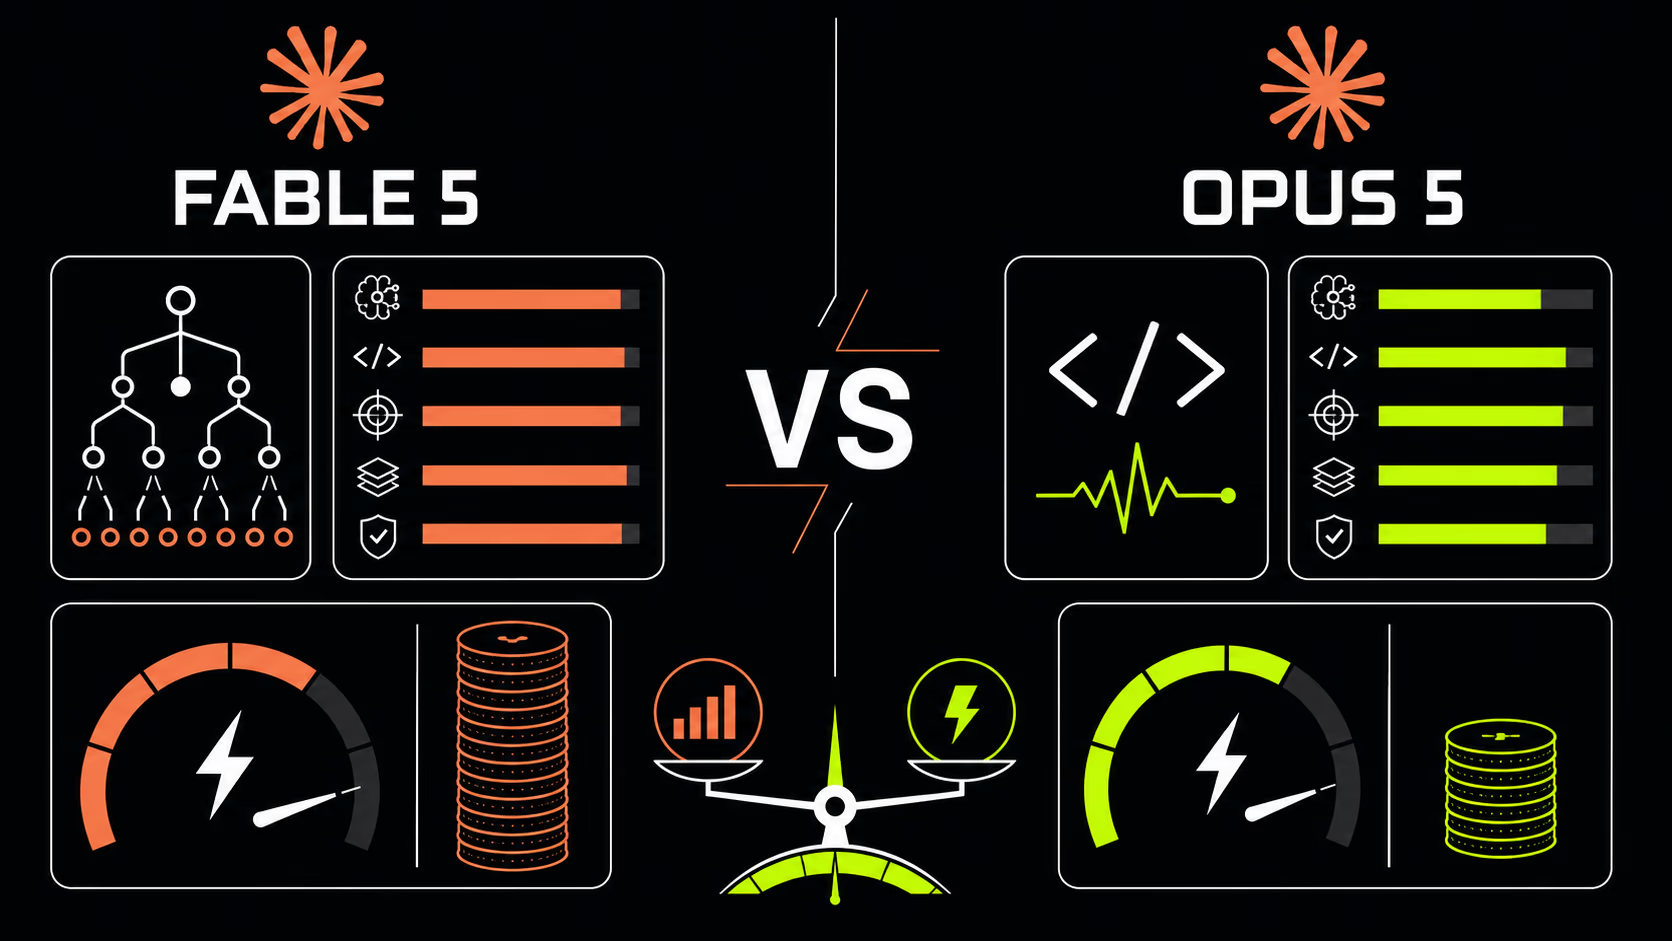
Il confronto tra Fable 5 e Opus 5 online è sempre lo stesso: tabella dei benchmark, prezzo per milione di token, conclusione. Va bene se paghi a consumo via API. Se stai su un abbonamento Pro o Max, quei numeri non rispondono alla tua domanda.
Qui trovi entrambe le risposte, più due cose che non ho visto scritte da nessuna parte in italiano: perché usando Fable a volte ti risponde Opus 5, e perché chi lo prova arriva a conclusioni opposte. Dove scrivo "Fable 5", il ragionamento vale anche per Fable 5.1, con le differenze indicate nel box qui sopra.
La risposta breve
Per la maggior parte del lavoro quotidiano oggi si parte da Opus 5. Costa circa la metà di Fable 5 e 5.1: 5 e 25 dollari per milione di token contro 10 e 50. Su parecchi compiti la differenza di risultato non si vede.
Fable si giustifica quando il compito è lungo, tocca molti file e deve reggere il filo per ore. Lì il divario si sente, e con la cache più economica di Fable 5.1 quelle sessioni lunghe costano anche meno di prima. Su tutto il resto stai pagando il doppio per un output che non distingueresti in un test alla cieca.
La domanda giusta dipende da come paghi
È la distinzione che cambia tutto e che nessun confronto fa.
Se paghi via API, a consumo
Qui il prezzo per token è la metrica corretta, ma va corretta con una cosa: quello che finisce in fattura è il costo per compito completato, non il prezzo di listino. Un modello più caro che risolve al primo colpo può costare meno di uno economico che ci prova tre volte e produce output più lunghi.
Una tecnica che riduce gli errori senza aumentare i costi è la prompt repetition.
Il metodo: prendi dieci compiti reali del tuo storico, falli girare su entrambi, e confronta la spesa totale fino al risultato accettato. Mezz'ora di lavoro che vale più di qualunque benchmark pubblicato.
Se stai su Pro o Max
Qui il prezzo per token non lo paghi tu, e diventa irrilevante. La risorsa scarsa è un'altra: la quota d'uso. È la lamentela più ricorrente negli scambi tra utenti italiani su Claude Code: il modello funziona bene, ma il limite si esaurisce in fretta. Dal 14 settembre 2026 la quota settimanale è anche scesa del 17% rispetto all'estate, come spiego in questo articolo sui nuovi limiti di Claude Code.
Il modello più pesante consuma la tua quota più rapidamente. Tradotto: usare Fable per tutto significa restare a piedi a metà settimana. La strategia che funziona è la stessa che si usa in cucina, il fuoco alto solo quando serve:
- Sonnet 5 per il lavoro di volume: modifiche circoscritte, riformulazioni, estrazione dati.
- Opus 5 come default quando serve ragionare.
- Fable 5.1 per il pezzo difficile della giornata, non per tutta la giornata.
Su come contenere il consumo indipendentemente dal modello ho scritto una guida dedicata, e il confronto tra i piani sta nell'articolo sui costi di Claude Code.
Perché usando Fable a volte risponde Opus 5
Questa è la parte che genera più confusione e che non trovi spiegata in italiano.
Fable esce con salvaguardie aggiuntive su alcuni ambiti sensibili: biologia, cybersecurity, ricerca sui modelli. Quando una richiesta rientra in quelle aree, la risposta arriva dal modello immediatamente sotto, cioè Opus 5. Non è un guasto e non è un declassamento del tuo account: è un meccanismo di instradamento previsto.
Con Fable 5 Anthropic aveva dichiarato di aver tarato quei filtri in modo conservativo, quindi ogni tanto scattavano anche su richieste innocue, secondo la loro stima in meno del 5% delle sessioni.
Con Fable 5.1 le tutele sono state rese più precise: circa il 60% di interventi in meno sulla cybersecurity in Claude Code e l'85% in meno sulle richieste benigne di biologia. Fable 5.1 può anche essere usato per cercare vulnerabilità nel software, mentre penetration testing, exploit e scansione di binari restano dirottati sui modelli Opus.
La conseguenza pratica resta importante per chi confronta: se stai valutando Fable su un compito che tocca quelle aree, potresti star valutando Opus 5 senza accorgertene. È uno dei motivi per cui i test informali danno risultati incoerenti.
Perché chi lo prova arriva a conclusioni opposte
Nelle discussioni tra sviluppatori si leggono due verdetti inconciliabili. Da una parte chi dice che nei propri flussi di coding la qualità è indistinguibile da quella di Opus 4.6. Dall'altra chi lo considera un salto netto e non tornerebbe indietro. Un recensore lo descrive come qualitativamente diverso proprio sui compiti lunghi e multi-file.
Non si contraddicono: stanno misurando compiti diversi.
- Compito corto e ben definito: scrivi questa funzione, sistema questo bug. La differenza tende a zero. Chi lavora così non vede il salto, e ha ragione lui.
- Compito lungo con molti vincoli: riprogetta questo modulo tenendo conto di sei regole. Qui il divario si apre. Chi lavora così vede il salto, e ha ragione anche lui.
- Compito che tocca aree sensibili: vedi il paragrafo sopra, forse non stavi nemmeno provando Fable.
Prima di fidarti di un'opinione trovata online, guarda che tipo di lavoro fa chi la scrive. Se non assomiglia al tuo, non ti dice niente.
Quando Fable vale il doppio
- Refactoring estesi su codice che non hai scritto tu, dove serve tenere insieme molti file contemporaneamente.
- Compiti agentici lunghi, in cui l'errore al passaggio tre si propaga fino al dodicesimo. Con la cache di Fable 5.1 sono anche quelli dove il costo scende di più.
- Analisi con vincoli in conflitto, dove la risposta giusta richiede di pesare requisiti che si contraddicono.
- Scrittura lunga con regole stringenti, dove la coerenza su molte pagine conta più della singola frase.
Quando Opus 5 basta e avanza
- Modifiche circoscritte, anche complesse, che stanno in pochi file.
- Debug di un comportamento già identificato.
- Qualsiasi cosa dove esiste un modo oggettivo di verificare se il risultato è giusto.
- Tutto il resto, per default. Si sale di modello quando si tocca un limite, non per prevenzione.
E se sei rimasto su Opus 4.8 o 4.6?
Non c'è fretta se funziona. Un modello su cui hai tarato i prompt vale più di uno nominalmente superiore su prompt da rifare. Quando decidi di muoverti, la procedura e i punti dove si rompono le cose li ho messi nell'articolo su se convenga ancora usare Opus 4.6.
Vale la pena sapere che Opus 5 è uscito il 24 luglio 2026 allo stesso prezzo di Opus 4.8, quindi passare non ti costa di più: qui il dettaglio su cosa cambia.
Sonnet 5, il gradino che spesso basta
Nel confronto tra i due modelli in cima si dimentica sempre il terzo. Per la maggior parte del lavoro ad alto volume Sonnet 5 è la scelta economicamente sensata, con una latenza più bassa che sull'esperienza d'uso pesa più di quanto si creda. Ne ho scritto nella guida dedicata.
Una nota sulla disponibilità
Se cerchi Fable 5 e trovi discussioni sulla sua rimozione: il modello è stato sospeso per pochi giorni a giugno 2026 per adeguarsi a controlli sull'export del Dipartimento del Commercio statunitense, e l'accesso è stato ripristinato il primo luglio. La ricostruzione della vicenda sta in questo articolo. Da settembre la versione corrente è Fable 5.1.
Come decidere in mezz'ora
- Prendi cinque compiti veri della settimana scorsa, non esempi.
- Falli girare su Opus 5. Segna quanti risultati accetteresti senza ritocchi.
- Solo i compiti scartati vanno rilanciati su Fable 5.1.
- Se Fable ne recupera zero o uno, hai la risposta: resta su Opus 5.
- Se ne recupera tre o più, guarda che tipo di compiti sono. Quello è il tuo criterio di instradamento, e vale più di qualsiasi tabella.
Se la scelta riguarda un prodotto o un processo aziendale e non il tuo uso personale, si valuta sui tuoi dati e non su un benchmark pubblico: scrivimi e la facciamo insieme.