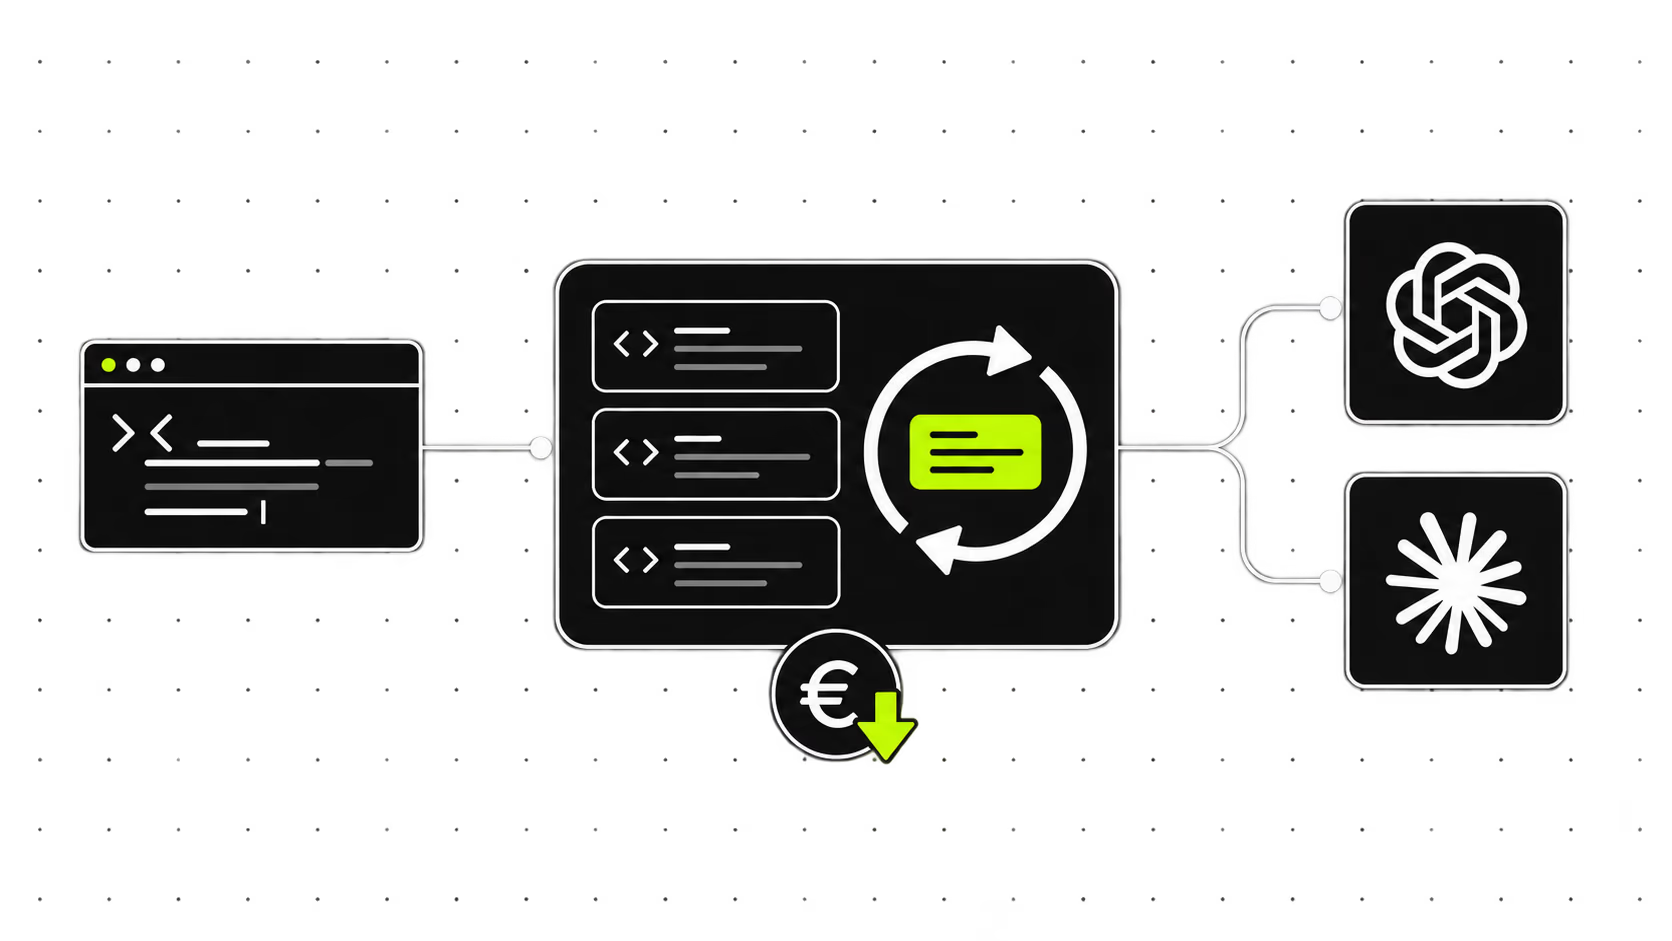
Il prompt caching è la voce che più spesso trovo sbagliata quando apro il codice di un agente AI che "costa troppo". Il modello va bene, i prompt vanno bene, ma ogni chiamata rielabora da zero le stesse istruzioni, le stesse definizioni degli strumenti e la stessa cronologia. E le paghi ogni volta a prezzo pieno.
In breve, al 4 novembre 2026: sui modelli Claude attuali la lettura dalla cache costa da un decimo a un quarantesimo dell'input normale e va attivata con cache_control; su GPT-6 la cache è automatica, dura almeno 30 minuti e dal 20 ottobre può durare 12 ore; su Gemini è automatica sopra i 4.096 token, e su Gemini 4 Argon esiste solo quella automatica.
Ottobre ha cambiato parecchi numeri. Il 7 ottobre Anthropic ha dimezzato la lettura dalla cache di Claude Sonnet 5.5, da 0,20 a 0,10 dollari per milione di token, e ha lanciato Claude Haiku 5.5, che legge dalla cache a 0,01. Il 20 ottobre OpenAI ha aggiunto la cache da 12 ore, e su GPT-6.1 Sol e GPT-6.1 Terra la lettura costa la metà rispetto agli altri modelli GPT-6. Qui metto in fila come funziona su GPT-6, Claude e Gemini, con i numeri ufficiali, il codice e l'errore che fa saltare la cache nove volte su dieci.
Cos'è il prompt caching in parole semplici
Quando un modello legge il tuo input, calcola degli stati intermedi (le cosiddette chiavi e valori della cache KV) per ogni token. Il prompt caching salva quel lavoro per la parte iniziale del prompt che non cambia, cioè il prefisso. Se la richiesta successiva inizia con lo stesso identico prefisso, il modello riprende da lì invece di ricalcolare tutto.
Tre effetti pratici:
- Costo: i token letti dalla cache costano una frazione di quelli normali, in genere un decimo o meno.
- Velocità: il tempo prima del primo token di risposta si accorcia, soprattutto con contesti lunghi.
- Nessun effetto sulla risposta: il modello genera l'output esattamente come farebbe senza cache. Non è una cache delle risposte, è una cache del lavoro fatto sull'input.
La regola che conta più di tutte: la cache funziona solo sul prefisso identico. Basta un carattere diverso all'inizio e tutto quello che viene dopo va ricalcolato.
Prompt caching a confronto: GPT-6, Claude e Gemini
I tre provider fanno la stessa cosa in modi diversi. Questa è la tabella che uso come riferimento quando scelgo come impostare un progetto.
| Voce | OpenAI (GPT-5.6 e GPT-6) | Anthropic (Claude) | Google (Gemini) |
|---|---|---|---|
| Attivo di default | Sì, modalità implicita | No, va attivato con cache_control | Sì, caching implicito dai modelli 2.5 in poi |
| Minimo di token | 1.024 token visibili | 512 su Opus 5.5, Sonnet 5.5, Haiku 5.5 e Fable 5.1; 1.024 su Sonnet 5 e Opus 4.8; 4.096 su Haiku 4.5 | 4.096 su Gemini 4 Argon, 3.8 Flash e 3.1 Pro Preview |
| Durata della cache | Almeno 30 minuti dall'ultimo uso; 12 ore su richiesta dal 20 ottobre 2026 (Responses API) | 5 minuti di default, 1 ora a pagamento | Implicito non garantito; esplicito con TTL di default di 1 ora, non disponibile su Gemini 4 Argon |
| Costo di scrittura | 1,25 volte l'input normale (30 minuti) o 2,5 volte (12 ore) | 1,25 volte (5 minuti) o 2 volte (1 ora) | Esplicito: token in cache più costo di conservazione per il tempo scelto |
| Costo di lettura | 0,1 volte l'input normale; 0,05 su GPT-6.1 Sol e GPT-6.1 Terra | 0,1 volte; 0,05 su Opus 5.5 e Sonnet 5.5; 0,025 su Fable 5.1 | Tariffa ridotta sui token in cache (su Gemini 4 Argon 0,10 $ per milione fino al 30 novembre, poi 0,20 $) |
| Controllo manuale | Breakpoint espliciti, fino a 4 scritture per richiesta | Fino a 4 breakpoint | Oggetti cache creati con l'API |
Una differenza pratica salta subito all'occhio: su OpenAI e Gemini la cache implicita parte da sola, su Claude no. Se usi Claude via API e non hai mai scritto cache_control nel codice, con buona probabilità stai pagando tutto a prezzo pieno.
Quanto si risparmia davvero: un conto su Claude Opus 5.5
Prendo un caso tipico: un agente con system prompt e definizioni degli strumenti per 20.000 token, che fa 50 chiamate in una sessione, ognuna entro 5 minuti dalla precedente. Uso i prezzi ufficiali di Claude Opus 5.5: 4 $ per milione di token in input, 5 $ per la scrittura in cache a 5 minuti, 0,20 $ per la lettura.
- Senza prompt caching: 50 chiamate per 20.000 token fanno 1 milione di token, cioè 4,00 $ solo per il prefisso ripetuto.
- Con prompt caching: una scrittura da 20.000 token costa 0,10 $, poi 49 letture per 980.000 token costano circa 0,20 $. Totale circa 0,30 $.
Sul solo prefisso si passa da 4 $ a 30 centesimi, un risparmio intorno al 92%. Il resto della richiesta (il messaggio nuovo dell'utente e l'output) si paga come sempre.
Ho rifatto lo stesso conto con i modelli più economici, ai prezzi in vigore al 4 novembre 2026:
- Claude Sonnet 5.5 (2 $ in input, 2,50 $ in scrittura, 0,10 $ in lettura dal 7 ottobre): senza cache 2,00 $, con la cache circa 0,15 $.
- Claude Haiku 5.5 (0,10 $ in input, 0,125 $ in scrittura, 0,01 $ in lettura, prompt sotto i 100.000 token): senza cache 0,10 $, con la cache poco più di un centesimo.
Con Haiku 5.5 le cifre assolute sono piccole, ma la proporzione è la stessa: oltre il 90% in meno sul prefisso. Attenzione però alla soglia di Haiku 5.5: se il prompt supera i 100.000 token, cache comprese, tutta la richiesta passa alla tariffa alta. Ne parlo nella guida a Claude Haiku 5.5.
Su GPT-6 il ragionamento è lo stesso con moltiplicatori diversi. La documentazione di OpenAI fa questo esempio: scrivere un prefisso una volta e rileggerlo nove volte costa 2,15 volte il suo prezzo normale, contro 10 volte senza cache. Se ti interessa il confronto dei prezzi base tra i modelli, l'ho fatto nell'articolo su GPT-6 Sol e Luna.
Come attivare il prompt caching su Claude
Il modo più semplice è il caching automatico: un solo campo cache_control al livello principale della richiesta. Il sistema mette il punto di cache sull'ultimo blocco utile e lo sposta in avanti man mano che la conversazione cresce.
import anthropic

client = anthropic.Anthropic()

response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=1024,
    cache_control={"type": "ephemeral"},
    system="Istruzioni stabili del mio agente...",
    messages=[{"role": "user", "content": "Domanda dell'utente"}],
)

print(response.usage)
Quando le parti del prompt cambiano con ritmi diversi, uso i breakpoint espliciti (fino a 4): uno dopo gli strumenti, uno dopo le istruzioni, uno dopo i documenti di contesto. L'ordine con cui Claude costruisce la cache è sempre strumenti, poi system, poi messaggi. Cambiare una definizione di strumento invalida tutto quello che segue.
Per la durata di 1 ora si aggiunge "ttl": "1h" dentro cache_control. Conviene quando tra una richiesta e l'altra passano più di 5 minuti ma meno di un'ora, per esempio un utente che risponde con calma in chat.
Come funziona il prompt caching su GPT-6
Su GPT-6 la cache implicita è già attiva e applica lo sconto ai prefissi riutilizzati entro 30 minuti. Le novità del 22 settembre e del 20 ottobre servono a controllarla meglio:
- Cache da 12 ore (dal 20 ottobre 2026): nella Responses API imposti
prompt_cache_options.ttlsu"12h"e il prefisso resta disponibile anche se le richieste arrivano a ore di distanza. La scrittura costa 2,5 volte l'input invece di 1,25: conviene quando lo stesso contesto lungo viene riletto molte volte nella giornata, per esempio un agente interno usato da più persone. - Lettura a metà prezzo su GPT-6.1 Sol e GPT-6.1 Terra: su questi modelli i token letti dalla cache costano 0,05 volte l'input normale invece di 0,1. Su GPT-6.1 Sol significa 0,10 $ per milione contro i 2 $ dell'input normale; su GPT-6.1 Terra, uscito il 26 ottobre a 1 $ in input e 5 $ in output, la lettura dalla cache costa 0,05 $. I dettagli di Sol sono in GPT-6.1 Sol: prezzi e novità.
- Breakpoint espliciti: con
prompt_cache_options.modeimpostato suexplicitdecidi tu dove finisce la parte da salvare, marcando il blocco conprompt_cache_breakpoint. Quello che sta dopo l'ultimo breakpoint non viene scritto in cache e non paga il sovrapprezzo di scrittura. - Cambiare il livello di ragionamento senza perdere la cache: invece di modificare
reasoning.effortnella richiesta, si aggiunge in coda un elementoconfiguration_update. - Preriscaldamento: con
prompt_cache_options.prewarmatrueil prefisso viene preparato prima che arrivi l'utente, senza generare output. - Dashboard e diagnostica: la piattaforma mostra il tasso di riscontri e, in caso di mancato riscontro, il motivo (per esempio strumenti cambiati).
{
  "model": "gpt-6.1-sol",
  "prompt_cache_options": { "mode": "explicit" },
  "input": [
    {
      "role": "developer",
      "content": [{
        "type": "input_text",
        "text": "Istruzioni stabili e materiale di riferimento...",
        "prompt_cache_breakpoint": { "mode": "explicit" }
      }]
    },
    { "role": "user", "content": "Domanda dell'utente..." }
  ]
}
Nella risposta controllo sempre usage.input_tokens_details.cached_tokens e cache_write_tokens: sono gli unici numeri che dicono se la cache sta lavorando davvero.
Gemini: cache implicita ed esplicita
Su Gemini il caching implicito è attivo di default, ma senza garanzia di risparmio: se la richiesta colpisce la cache, lo sconto arriva da solo. Il minimo sui modelli recenti come Gemini 3.8 Flash è di 4.096 token, quindi i prompt brevi restano fuori.
Per avere la garanzia serve il caching esplicito, disponibile con l'API generateContent sui modelli Gemini 3 e 2.5, ma non con la Interactions API e non su Gemini 4 Argon, che oggi ha solo la cache implicita. Su Argon c'è anche un dettaglio da sapere nelle conversazioni a più turni: la richiesta precedente viene messa in cache per intero solo se quella nuova aggiunge almeno 2.050 token. Si crea un oggetto cache con client.caches.create, gli si dà un TTL (di default 1 ora) e lo si richiama nelle richieste successive. Qui si paga anche la conservazione per il tempo scelto, quindi ha senso solo su contesti grandi riusati spesso: un manuale, un repository, un video da interrogare più volte.
L'errore che rompe il prompt caching più spesso
Il caso che vedo più spesso è sempre lo stesso: una data, un orario o un dato dell'utente messi all'inizio del system prompt. "Oggi è il 25 settembre, sono le 10:32, l'utente si chiama Marco..." e sotto 15.000 token di istruzioni fisse. Il prefisso cambia a ogni chiamata, quindi la cache non viene mai riletta: su Claude paghi pure il sovrapprezzo di scrittura ogni volta.
Le regole che applico:
- Prima lo stabile, poi il variabile: strumenti e istruzioni fisse in cima, date e dati dell'utente in fondo.
- Non toccare gli strumenti a metà sessione: se un agente deve usare meno strumenti, li disattivo (su OpenAI con
allowed_toolsotool_choice) invece di toglierli dalla lista. - Attenzione a memoria e riassunti: un nodo che riscrive o accorcia la cronologia a ogni turno cambia il prefisso. Nei flussi n8n con agente AI e memoria su database è la prima cosa da verificare.
- Chiavi JSON in ordine stabile: alcuni linguaggi riordinano le chiavi degli oggetti, e un ordine diverso è un prefisso diverso.
- Sotto la soglia non succede niente: su Claude un prompt troppo corto non dà errore, semplicemente non va in cache. Se i campi di scrittura e lettura sono entrambi a zero, il motivo è quasi sempre questo.
Come verifico che il prompt caching funzioni
Non mi fido mai dell'impostazione, guardo i numeri della risposta. Su Claude i campi sono cache_creation_input_tokens e cache_read_input_tokens: alla prima chiamata deve salire il primo, dalla seconda in poi il secondo. Su OpenAI guardo cached_tokens e il tasso di riscontri nella dashboard. Su Gemini il conteggio è nei metadati di utilizzo della risposta.
Se usi Claude Code invece dell'API diretta, la cache la gestisce lo strumento: lì il lavoro è tenere stabile il contesto, evitare di cambiare modello a metà e usare con criterio i comandi che compattano la sessione. Sui piani in abbonamento i conti sono diversi, li trovi nella guida ai prezzi di Claude.
Quando il prompt caching non conviene
Non è sempre un guadagno. Non ne vale la pena quando il prefisso è sotto la soglia minima e allungarlo non ha senso, quando le richieste sono rare (più di 5 minuti di pausa su Claude, o di un'ora con la cache lunga; più di 30 minuti su GPT-6, se non usi la cache da 12 ore) o quando ogni chiamata ha un contesto diverso. In questi casi con la scrittura in cache paghi solo il sovrapprezzo.
Dove invece rende di più: agenti con molti strumenti, chatbot con istruzioni lunghe, analisi ripetute sugli stessi documenti e qualsiasi flusso con decine di chiamate a catena. Se stai costruendo uno di questi e vuoi capire dove perdi soldi, è il lavoro che faccio nei progetti di automazione AI: puoi scrivermi dalla pagina contatti.