Partiamo da un fatto scomodo: Claude Code non è gratis. È incluso nei piani Pro e Max di Claude oppure si paga a consumo via API, e il piano Free non lo include. Eppure "claude code gratis" è una delle ricerche più frequenti tra gli sviluppatori italiani, e la risposta esiste.
Nel 2026 ci sono cinque strade che funzionano davvero, divise in due gruppi:
- Con il vero Claude: i crediti iniziali delle API di Anthropic, per una prova, e il programma Claude for Open Source, se sei un maintainer idoneo.
- Con l'interfaccia di Claude Code e un altro modello dietro: Ollama in locale (zero costi, zero limiti, offline), OpenRouter (tier gratuito cloud, con rate limit) e NVIDIA NIM (crediti gratuiti, tramite un proxy come LiteLLM).
In questa guida trovi il setup di tutte e cinque, i modelli che ti consiglio, i requisiti hardware e, alla fine, cosa perdi rispetto al Claude vero quando usi un modello alternativo.
Aggiornato il 24 settembre 2026: aggiunte le due strade ufficiali (crediti API e Claude for Open Source), corretti i rate limit di OpenRouter e la configurazione delle variabili.
Claude gratis e Claude Code gratis non sono la stessa cosa
Molti arrivano qui cercando "come avere Claude gratis", quindi chiarisco subito la differenza. Claude, l'assistente in chat su claude.ai e nelle app, ha un piano Free: ti registri e lo usi senza pagare, con limiti di messaggi. Da luglio 2026 il piano Free usa Claude Sonnet 5 come modello predefinito e include ricerca web, caricamento file, Projects e Artifacts.
Claude Code è un'altra cosa: l'agente da terminale che legge il tuo repository, modifica file ed esegue comandi. Non è nel piano Free e non esiste una versione gratuita ufficiale. Non c'è nemmeno un periodo di prova sui piani Pro o Max. Se ti bastava la chat, il piano Free di Claude è la risposta e puoi fermarti qui.
Se hai già provato Claude Code con Ollama e non ha funzionato, salta direttamente alla sezione sul contesto: nove volte su dieci il problema è quello, e non è colpa del modello.
Cos'è Claude Code e perché funziona anche con altri modelli
Claude Code è lo strumento di coding agentico di Anthropic che vive nel tuo terminale. A differenza degli assistenti di chat, può analizzare interi repository, creare e modificare file, eseguire comandi e ragionare su problemi complessi di programmazione.
Il punto chiave per questa guida: Claude Code parla con il modello tramite un endpoint API, e quell'endpoint si può cambiare con una variabile d'ambiente (ANTHROPIC_BASE_URL). Tutto ciò che espone un'API compatibile con il formato Anthropic Messages può fare da "cervello" al posto dei server Anthropic. Se non hai ancora installato Claude Code, nella cheatsheet trovi installazione e comandi base.
Le due strade ufficiali per usare il vero Claude Code gratis
1. I crediti iniziali delle API di Anthropic
È la strada meno conosciuta ed è quella da cui partirei se non hai mai usato Claude Code. Creando un account sulla console per sviluppatori di Anthropic (platform.claude.com) ricevi un credito iniziale una tantum. Anthropic non pubblica la cifra esatta: viene riportata intorno ai 5 dollari.
Con quel credito usi il vero Claude Code con i veri modelli Claude sul tuo codice. Due limiti da sapere: i crediti non si rinnovano e scadono dopo 14 giorni, quindi trattali come una prova, non come una scorta. Nota anche che l'account della console è separato da quello di claude.ai.
Il setup è breve: crei l'account, controlli nella sezione Billing che il credito ci sia, crei una chiave API, la esporti e lanci Claude Code dalla cartella del progetto.
export ANTHROPIC_API_KEY="sk-ant-la-tua-chiave"
cd ~/progetti/mia-app
claude
Dentro la sessione, il comando /status ti conferma che stai usando la chiave API e quindi i crediti della console. Il consiglio: spendi quei crediti su un task vero, un bug che attraversa tre file o un modulo da rifattorizzare. È l'unico modo per capire se Claude Code vale i 20 dollari al mese del piano Pro. Se decidi di passare al piano, qui spiego come tenere bassi i consumi di token.
2. Il programma Claude for Open Source
Se mantieni progetti open source usati da altri, controlla questo prima di tutto il resto. Anthropic ha lanciato il programma a febbraio 2026 e lo ha ampliato a luglio: i maintainer e i contributor idonei ricevono sei mesi di Claude Max 20x gratis, il piano da 200 dollari al mese, Claude Code compreso.
I requisiti pubblicati sono più ampi di quanto si pensi. Basta rientrare in uno di questi casi:
- Maintainer di pacchetti con almeno 500 repository dipendenti, 100 pacchetti dipendenti o 200.000 download mensili su npm, PyPI, crates.io, RubyGems o registri simili.
- Committer di progetti di fondazioni o linguaggi riconosciuti, come CPython, Rust, Node.js, Apache, CNCF, Kubernetes, kernel Linux, Django o Rails.
- Almeno 100 pull request accettate in repository non tuoi negli ultimi dodici mesi.
- Un repository che nell'ultimo anno ha avuto almeno 20 contributor esterni con PR accettate.
- Maintainer di progetti con punteggio di criticità OpenSSF pari o superiore a 0,4.
Il programma è limitato a 10.000 persone e le candidature vengono valutate in modo continuo. Copre l'abbonamento, non i crediti API: è un piano personale, non qualcosa da collegare a una pipeline di CI.
Metodo 3: Claude Code gratis in locale con Ollama (senza limiti, offline)
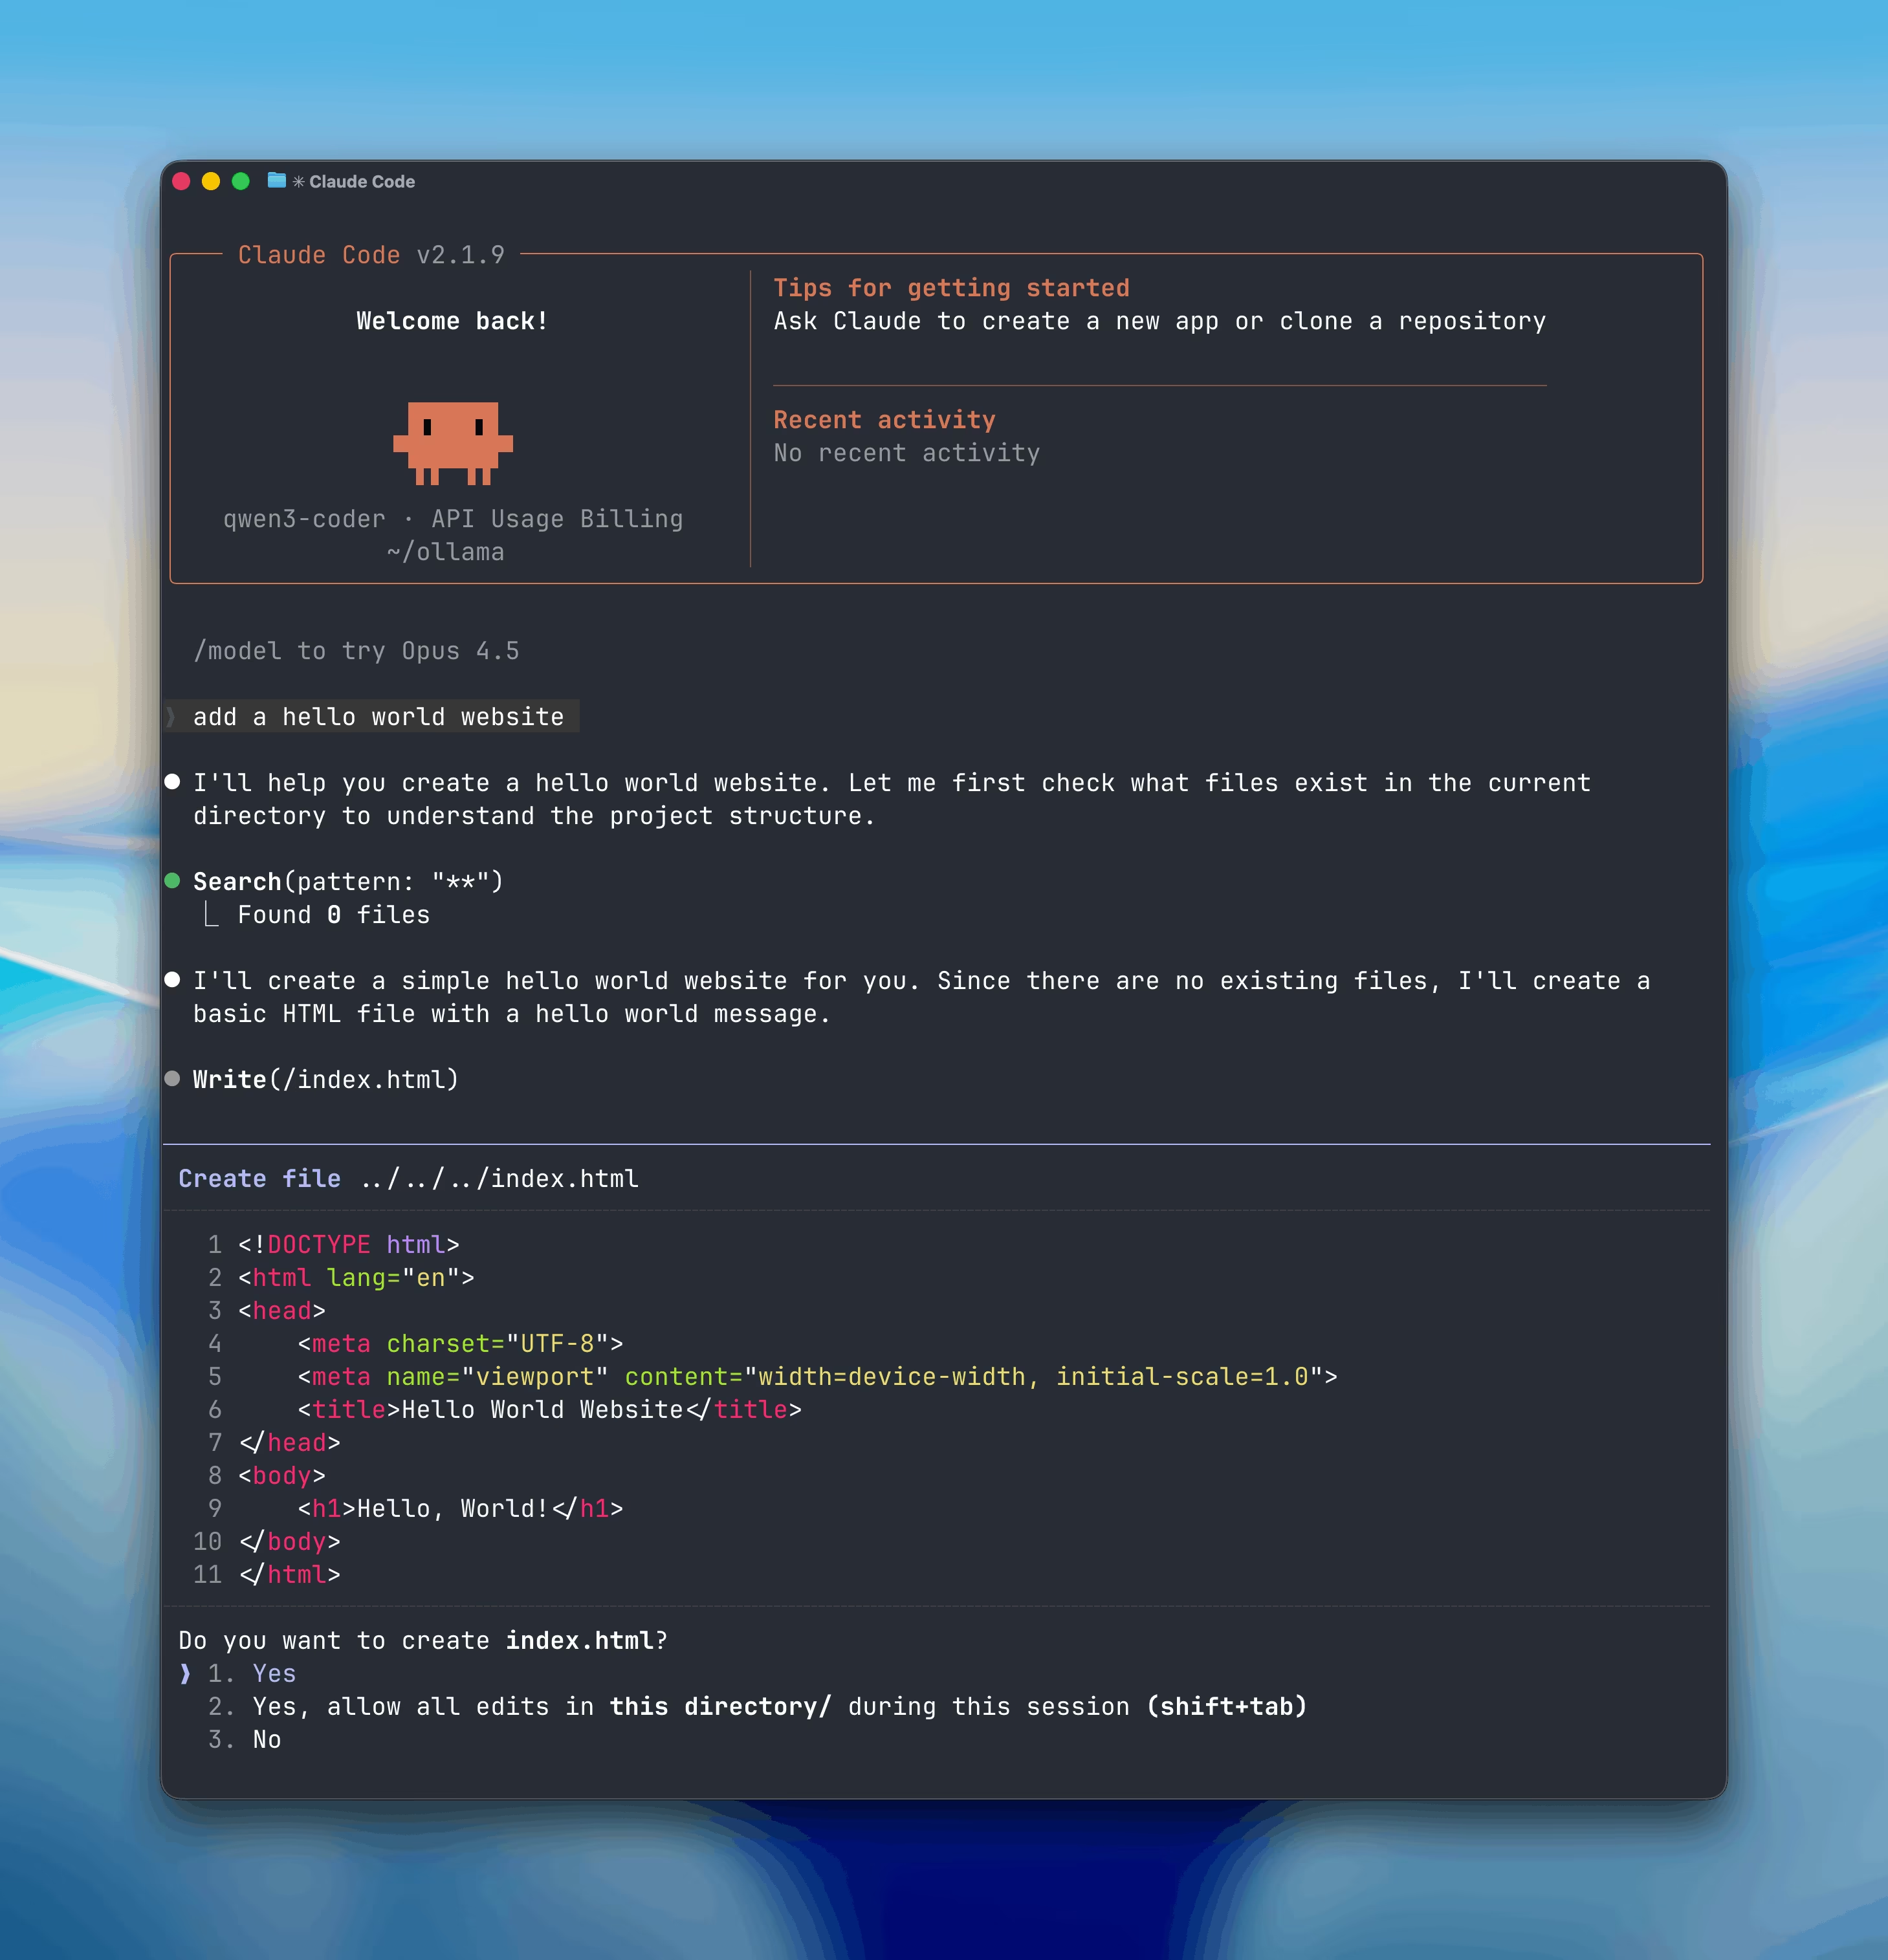
Dalla versione 0.14.0 Ollama espone nativamente un endpoint compatibile con l'Anthropic Messages API. Claude Code continua a funzionare come prima, gestendo pianificazione, navigazione del codice e modifiche, ma le richieste vanno a un modello locale invece che ai server Anthropic. Se ti interessa il lato normativo della privacy dei dati, ho raccontato il voto europeo su Chat Control e cosa cambia per chi usa modelli in locale.
I vantaggi: privacy totale, perché il codice non lascia la tua macchina; zero costi operativi dopo l'investimento hardware; nessun rate limit, l'unico limite è la velocità del tuo hardware; funziona offline una volta scaricato il modello.
Requisiti hardware: cosa ti serve per iniziare
I modelli AI per coding richiedono memoria significativa, e la scelta del modello giusto dipende dalla tua configurazione.
Per modelli piccoli (7B-14B) come Qwen2.5-Coder:7b servono almeno 8-16 GB di RAM e preferibilmente una GPU con 8 GB di VRAM. Vanno bene su laptop e PC di fascia media per task di coding quotidiani.
Per modelli medi (30B) come Qwen3-Coder:30b il requisito sale a 20+ GB di VRAM o 32 GB di RAM per l'esecuzione su CPU con quantizzazione. Il tag qwen3-coder:30b pesa circa 19 GB di download. Offrono capacità agentiche molto più avanzate ma richiedono hardware dedicato.
Per modelli grandi (480B) come Qwen3-Coder-480B parliamo di 250+ GB di memoria unificata: roba da data center o da Ollama Cloud, non da hardware consumer.
La quantizzazione gioca un ruolo cruciale: un modello 7B in formato Q4_K_M occupa circa 4-5 GB invece dei 26 GB della versione FP16, con una perdita di qualità minima. Se il tuo hardware è limitato, preferisci sempre versioni quantizzate. Se stai valutando di comprare una macchina apposta, ho messo insieme una guida per fasce di prezzo, e qui trovi quando l'hardware conviene davvero rispetto al cloud.
Installazione passo passo
Scarica l'ultima versione di Ollama (0.14.0 o superiore) dal sito ufficiale, disponibile per Windows, macOS e Linux. I dettagli sull'endpoint compatibile Anthropic sono nella documentazione di Ollama; le variabili d'ambiente di Claude Code sono nella documentazione ufficiale di Claude Code.
Poi scarica un modello adatto al coding. Per iniziare ti consiglio Qwen3-Coder, ottimizzato per task agentici:
ollama pull qwen3-coder:30bSe hai hardware più limitato, scegli la versione più leggera:
ollama pull qwen2.5-coder:7bVerifica che Ollama sia in esecuzione con:
ollama serveIl server si avvia sulla porta 11434 per default.
Configurazione di Claude Code con Ollama
Opzione 1: variabili d'ambiente temporanee
export ANTHROPIC_BASE_URL=http://localhost:11434
export ANTHROPIC_AUTH_TOKEN=ollama
export ANTHROPIC_API_KEY=ollama
Poi lancia Claude Code specificando il modello:
claude --model qwen3-coderLe versioni recenti di Ollama hanno anche una scorciatoia che imposta tutto e ti fa scegliere il modello da una lista:
ollama launch claudeOpzione 2: configurazione permanente
Aggiungi le variabili al tuo file di profilo shell (~/.bashrc, ~/.zshrc o equivalente):
echo 'export ANTHROPIC_BASE_URL=http://localhost:11434' >> ~/.bashrc
echo 'export ANTHROPIC_AUTH_TOKEN=ollama' >> ~/.bashrc
echo 'export ANTHROPIC_API_KEY=ollama' >> ~/.bashrc
source ~/.bashrc
I valori di AUTH_TOKEN e API_KEY sono segnaposto richiesti dal protocollo ma non vengono validati da Ollama: puoi usare qualsiasi stringa.
Il passo che quasi tutti saltano: alzare la finestra di contesto
Se hai seguito i passaggi qui sopra e il risultato è deludente, con il modello che si inventa file inesistenti o entra in loop, quasi certamente non è colpa del modello: è il contesto troppo corto. È il motivo principale per cui la maggior parte dei setup con Claude Code e Ollama viene abbandonata dopo mezz'ora.
Il problema in due righe: Claude Code invia un system prompt da circa 18.000 token prima ancora che tu scriva qualcosa. Se la finestra di contesto del server è più piccola, Ollama taglia in silenzio quello che avanza. Non ricevi nessun errore: il modello risponde comunque, ma ha letto solo la coda del tuo input. Da lì nascono le allucinazioni.
Quanto vale il default? Dipende dalla build, e la documentazione di Ollama stessa non è concorde: le FAQ indicano 4.096 token, il riferimento del Modelfile parla di 2.048, e la pagina sulla context length dice che il valore viene scelto in base alla VRAM disponibile (4K sotto i 24 GiB, 32K tra 24 e 48 GiB, 256K oltre). La lezione utile è proprio questa discordanza: leggi il valore dal tuo server invece di fidarti di una pagina, inclusa questa.
La raccomandazione di Ollama per Claude Code è di almeno 32K token, con 64K come soglia comoda per il lavoro agentico.
Prova rapida. Se Ollama gira come servizio, fermalo e riavvialo a mano con il contesto alzato:
sudo systemctl stop ollama.service
OLLAMA_CONTEXT_LENGTH=65536 ollama serve
Attenzione al nome: OLLAMA_CONTEXT_LENGTH è la variabile attuale. Molte guide più vecchie usano OLLAMA_NUM_CTX, che nelle versioni recenti potrebbe non avere effetto.
Soluzione permanente. Il modo più solido è cucire il contesto dentro una variante del modello con un Modelfile. Sopravvive ai riavvii e vale per qualsiasi client si colleghi:
# Salva come Modelfile (senza estensione)
FROM qwen3-coder:30b
PARAMETER num_ctx 65536
Poi costruisci la variante e passala a Claude Code:
ollama create qwen3-coder-cc-64k -f ./Modelfile
claude --model qwen3-coder-cc-64k
Non ti riscarica i 19 GB del modello: applica solo un nuovo layer di configurazione sopra quello esistente.
Due trappole da conoscere. La prima: num_ctx si scrive con l'underscore, non con il trattino, e se sbagli fallisce in silenzio. La seconda: l'ordine di precedenza è parametro API, poi variabile d'ambiente, poi PARAMETER del Modelfile, poi default. Se un modello ha già num_ctx fissato nel suo Modelfile, quel valore batte la variabile d'ambiente.
Come verificare che sia servito a qualcosa. Su alcune build ollama ps mostra il contesto applicato in una colonna dedicata. Il metodo che funziona ovunque è guardare prompt_eval_count nella risposta dell'API: è il numero di token effettivamente letti in ingresso. Se resta inchiodato su un valore molto più basso di quello che hai mandato, il troncamento c'è ancora.
Il prezzo da pagare è VRAM. La KV cache cresce con la finestra di contesto, e raddoppiare num_ctx raddoppia grosso modo la memoria occupata dal contesto, che si somma a quella dei pesi. Su una scheda da 24 GB, 64K è gestibile con un 30B quantizzato a Q4. Se la KV cache non entra più in VRAM, Ollama sposta parte del carico sulla RAM di sistema: continua a funzionare, ma la generazione può rallentare di un ordine di grandezza. Sali per gradi tenendo d'occhio nvidia-smi e ollama ps.
Due limiti del layer di compatibilità di Ollama
Prima di giudicare i risultati, sappi che il layer di Ollama non replica tutto. La prompt cache di Anthropic non si applica, quindi ogni richiesta rielabora da zero system prompt e cronologia: qui non costa di più, ma è più lento. E il campo tool_choice viene ignorato: Claude Code lo usa ogni tanto per forzare una chiamata a uno strumento specifico, e quando serve l'agente può scegliere lo strumento sbagliato e girare in loop.
Modelli consigliati per Claude Code
Il modello deve supportare il tool calling. Un agente lavora così: legge un file, scrive una patch, lancia il test, legge l'errore, riprova. Un modello che non sa emettere una chiamata a strumento descriverà la modifica a parole invece di applicarla, e l'agente si blocca. Prima di scaricare qualsiasi cosa, cerca l'etichetta tools nella pagina del modello su ollama.com.
Vale la pena essere onesti anche su un altro punto: anche con i modelli giusti l'aderenza al formato non è perfetta. Diversi sviluppatori riportano che Qwen3-Coder ogni tanto risponde con costrutti che Claude Code non si aspetta, e l'agente inciampa. Funziona, ma non con la fluidità del Claude originale.
Qwen3-Coder resta il riferimento tra i modelli open source per coding. Disponibile da 30B a 480B parametri, offre 256K token di contesto nativi e capacità agentiche avanzate. La versione 30B è il punto di equilibrio per la maggior parte degli sviluppatori.
Devstral Small 2 è l'alternativa che la community indica quando Qwen dà problemi di tool calling: nato per il lavoro agentico su codebase reali.
Granite 4 è l'opzione da valutare se sei stretto di VRAM ma ti serve contesto lungo: è pensato proprio per ridurre l'occupazione di memoria a parità di finestra.
Qwen2.5-Coder è l'alternativa più leggera, da 0.5B a 32B parametri. La versione 7B offre un ottimo rapporto qualità/risorse su hardware consumer.
GLM 5.2 è la sorpresa del 2026 per chi ha poca RAM: nella guida dedicata spiego come farlo girare con 25 GB. Sul fronte Qwen, Qwen 3.8 Flash e Next sono i modelli più recenti che ho provato in locale: se hai la memoria per farli girare, valgono un test prima di scegliere il 30B.
DeepSeek-Coder-V2 usa un'architettura MoE (Mixture of Experts), con la versione Lite che offre 128K di contesto con soli 2.4B parametri attivi su 16B totali.
Utilizzo con Ollama Cloud
Se non hai hardware sufficiente, Ollama offre anche modelli cloud accessibili con la stessa configurazione. I modelli cloud mantengono la loro context length completa e non richiedono risorse locali:
claude --model glm-4.7:cloud
claude --model minimax-m2.1:cloud
MiniMax M2, in particolare, è costruito per workflow di coding e agentici. Attenzione: il tier cloud di Ollama ha limiti d'uso gratuiti, oltre i quali serve un piano. Il catalogo cambia spesso, quindi controlla i nomi disponibili prima di copiarli.
Mappare i nomi dei modelli
Alcuni tool e script si aspettano nomi di modelli nel formato Anthropic. Se ti serve compatibilità con qualcosa di già scritto, puoi creare un alias con ollama cp:
ollama cp qwen3-coder-cc-64k claude-sonnet-5Da quel momento, quando il tool richiede quel nome, Ollama servirà la tua variante locale. Usalo solo se hai davvero uno script vecchio da accontentare: per l'uso normale è più chiaro passare il nome reale a claude --model.
Metodo 4: Claude Code gratis con OpenRouter (nessun hardware)
Se il tuo laptop non regge un modello da 30B, OpenRouter è la via più semplice: è un aggregatore di modelli cloud con un tier gratuito (modelli con suffisso :free) e, cosa fondamentale, espone anche un endpoint compatibile con il formato Anthropic. Claude Code ci si collega senza proxy.
Setup in quattro passi:
- Crea un account gratuito su openrouter.ai e genera una API key dalla sezione Keys. Per usare solo i modelli gratuiti non serve la carta.
- Se in passato hai fatto login in Claude Code con un account Anthropic, esegui
/logoutdentro la CLI e riaprila: una sessione salvata scavalca le variabili. - Imposta le variabili d'ambiente puntando a OpenRouter.
- Lancia Claude Code con un modello free.
export ANTHROPIC_BASE_URL=https://openrouter.ai/api
export ANTHROPIC_AUTH_TOKEN=sk-or-la-tua-chiave
export ANTHROPIC_API_KEY=""
claude --model deepseek/deepseek-r1:free
Attenzione alla terza riga: ANTHROPIC_API_KEY va impostata esplicitamente a stringa vuota, altrimenti Claude Code può tornare ad autenticarsi con Anthropic. Con /status dentro la sessione controlli che il base URL sia quello di OpenRouter.
Modelli free che reggono bene i task agentici: DeepSeek R1 e le varianti Qwen3-Coder quando sono disponibili nel tier gratuito. Esiste anche openrouter/free, un instradamento automatico che sceglie un modello gratuito disponibile: comodo, ma la qualità varia molto. La lista cambia spesso: controlla il filtro "free" su OpenRouter prima di scegliere.
Il rovescio della medaglia sono i rate limit: 20 richieste al minuto e 50 al giorno se non hai mai acquistato crediti. Con un acquisto una tantum di 10 dollari la quota giornaliera sale a 1.000 richieste e resta lì anche quando il saldo torna a zero. Per una sessione con Claude Code, che fa decine di chiamate per un singolo task, 50 richieste finiscono in fretta, e anche i tentativi falliti contano. Ricorda infine che il codice passa dai server del provider del modello: niente privacy totale come con Ollama.
Metodo 5: Claude Code con NVIDIA NIM (crediti gratis e proxy)
NVIDIA NIM offre API sui modelli NVIDIA e open (Nemotron, Llama, Qwen) con crediti gratuiti all'iscrizione su build.nvidia.com. Il problema: l'API di NIM è in formato OpenAI, non Anthropic, quindi Claude Code non ci parla direttamente. Serve un traduttore in mezzo, e il più usato è LiteLLM.
pip install litellm

export NVIDIA_NIM_API_KEY=nvapi-la-tua-chiave
litellm --model nvidia_nim/qwen/qwen2.5-coder-32b-instruct --port 4000
Lascia il proxy in esecuzione e, in un altro terminale, punta Claude Code a LiteLLM:
export ANTHROPIC_BASE_URL=http://localhost:4000
export ANTHROPIC_AUTH_TOKEN=nim
claude
LiteLLM riceve la richiesta in formato Anthropic da Claude Code, la converte in formato OpenAI e la inoltra a NIM. Lo stesso schema funziona con qualsiasi provider compatibile con OpenAI: Groq, Together, Mistral, o un vLLM che gira su un server tuo. È il metodo più flessibile, ma anche quello con un pezzo in più da tenere acceso.
Confronto rapido: quale metodo scegliere
| Metodo | Modello Claude vero? | Costo | Limiti | Offline | Privacy |
|---|---|---|---|---|---|
| Crediti API iniziali | Sì | 0 € (una tantum) | Credito piccolo, scade dopo 14 giorni | No | Quella di Anthropic |
| Claude for Open Source | Sì (Max 20x) | 0 € per 6 mesi | Serve essere idonei, posti limitati | No | Quella di Anthropic |
| Ollama | No | 0 € | Nessuno, solo l'hardware | Sì | Totale |
| OpenRouter | No | 0 € (tier free) | 50 richieste al giorno, 1.000 dopo 10 $ una tantum | No | Media |
| NVIDIA NIM | No | 0 € (crediti) | Crediti esauribili | No | Media |
Come scegliere in una riga: se vuoi capire se Claude Code fa per te, usa i crediti API; se mantieni un progetto open source, candidati al programma OSS; se ti serve privacy o lavoro offline, Ollama; se vuoi uso continuativo senza hardware, OpenRouter.
Cosa perdi rispetto a Claude vero (onestamente)
Con Ollama, OpenRouter e NIM l'interfaccia di Claude Code resta identica, ma il modello dietro non è Claude, e si sente in tre situazioni: task agentici lunghi con decine di passaggi, ragionamento su codebase grandi e strumenti che richiedono la modalità "thinking". Per bugfix, refactoring locale, script e boilerplate la differenza è marginale; per rifattorizzare un monolite da solo, no.
C'è poi il tema dell'aderenza al protocollo: gran parte di quello che rende Claude Code efficace non è solo il modello, ma il modo in cui gli strumenti sono cablati insieme. Un modello open che non segue quelle convenzioni alla lettera ti costringe a più tentativi per lo stesso risultato.
Se lo usi per lavoro tutti i giorni, il piano Pro a 20 dollari al mese include Claude Code con i modelli veri e spesso costa meno dell'elettricità di una GPU accesa otto ore. La combinazione che uso io: Ollama per esplorazione e task ripetitivi, Claude vero per il lavoro che conta.
Integrazione con SDK esistenti
Se hai già applicazioni che usano l'Anthropic SDK, puntarle a Ollama è semplice: basta cambiare il base URL.
Esempio in Python:
import anthropic

client = anthropic.Anthropic(
    base_url='http://localhost:11434',
    api_key='ollama',  # richiesto ma ignorato
)

message = client.messages.create(
    model='qwen3-coder',
    max_tokens=1024,
    messages=[
        {'role': 'user', 'content': 'Scrivi una funzione Python per controllare se un numero è primo'}
    ]
)

print(message.content[0].text)
Esempio in JavaScript/TypeScript:
import Anthropic from '@anthropic-ai/sdk';

const anthropic = new Anthropic({
  baseURL: 'http://localhost:11434',
  apiKey: 'ollama',
});

const message = await anthropic.messages.create({
  model: 'qwen3-coder',
  max_tokens: 1024,
  messages: [
    { role: 'user', content: 'Implementa un binary search tree in TypeScript' }
  ],
});

console.log(message.content[0].text);
Risoluzione dei problemi più comuni
Il modello si inventa file, ignora istruzioni o entra in loop: è il sintomo classico del contesto troppo corto. Vai alla sezione sulla finestra di contesto e alza num_ctx a 64K.
Il modello descrive le modifiche invece di applicarle: il modello non supporta il tool calling. Controlla l'etichetta tools sulla pagina del modello su ollama.com e cambiane uno.
Claude Code continua a chiedere il login: un base URL raggiungibile non basta come credenziale. Imposta ANTHROPIC_AUTH_TOKEN nella shell o in ~/.claude/settings.json, che vengono letti prima della procedura di primo avvio.
Un avviso all'avvio parla di due credenziali: sono attivi sia la credenziale del gateway sia un login salvato. Esegui /logout per togliere il login salvato.
Errore "does not support thinking": alcuni modelli più piccoli non supportano la modalità "thinking" di Claude Code. Prova con un modello più capace come qwen3-coder:30b.
Risposte lente o timeout: verifica che il modello sia caricato in memoria con ollama list. Se hai appena alzato il contesto, controlla che la KV cache non abbia spinto parte del modello in RAM di sistema.
Errori 500 con richieste grandi: richieste molto grandi (system prompt oltre i 18 KB, 20 o più tool) possono causare errori con alcuni modelli cloud. Prova con modelli locali o riduci la complessità della richiesta.
Errore 429 su OpenRouter: hai esaurito il rate limit del modello free. Cambia modello o aspetta il reset giornaliero.
Errori 400 o di header con proxy e gateway: alcune funzioni beta di Claude Code mandano campi che LiteLLM o altri gateway non gestiscono. Prova a impostare CLAUDE_CODE_DISABLE_EXPERIMENTAL_BETAS=1 e DISABLE_PROMPT_CACHING=1.
Alternative: Olla e altri proxy
Oltre alla compatibilità nativa di Ollama e a LiteLLM, esistono progetti come Olla che fanno da traduttori API più avanzati, con bilanciamento del carico tra più backend (Ollama, LM Studio, vLLM), failover automatico e unificazione dei modelli. È utile in setup aziendali con più server GPU.
Se invece il modello in locale deve servire un team, con i documenti dell'azienda e permessi diversi per reparto, è un altro lavoro: lo descrivo nella pagina sull'installazione di un LLM in locale per aziende.
Un'altra opzione è ollama-anthropic-shim, un progetto GitHub con un layer di compatibilità più leggero e una mappatura configurabile dei modelli. Se invece vuoi un agente di coding nativamente gratuito e multi-provider, OpenCode è l'alternativa che ho confrontato con Claude Code: nasce per parlare con modelli diversi, invece di aspettarsi le convenzioni di Anthropic.
Leggi anche
- Claude Code vs Codex: limiti, prezzi e chi conviene
- AI in locale: quanto costa davvero e quando conviene (2026)
- Miglior computer per AI 2026: guida per fasce di prezzo
- PC per AI in locale: workstation, mini PC e benchmark
- GLM 5.2 in locale con 25 GB di RAM: la guida
- Muse Spark 1.3: prezzi, API e coding
Conclusioni
Claude Code gratis non esiste in senso stretto, ma a settembre 2026 ci sono cinque modi concreti per usarlo senza pagare. Se vuoi il vero Claude, parti dai crediti API della console o, se sei un maintainer, dal programma Claude for Open Source. Se ti basta l'interfaccia con un altro modello, Ollama è la scelta per privacy e zero limiti, OpenRouter per partire in cinque minuti senza GPU, NIM con LiteLLM per la massima flessibilità sui provider.
Se usi Ollama e dovessi ridurre tutta questa guida a una riga: alza la finestra di contesto a 64K e scegli un modello con il tag tools. Sono i due passaggi che separano un setup che funziona da uno che abbandoni dopo mezz'ora.
Se stai cercando supporto per portare workflow di sviluppo con AI nel tuo team o vuoi esplorare soluzioni di sviluppo web app che integrano intelligenza artificiale, contattami per una consulenza personalizzata.