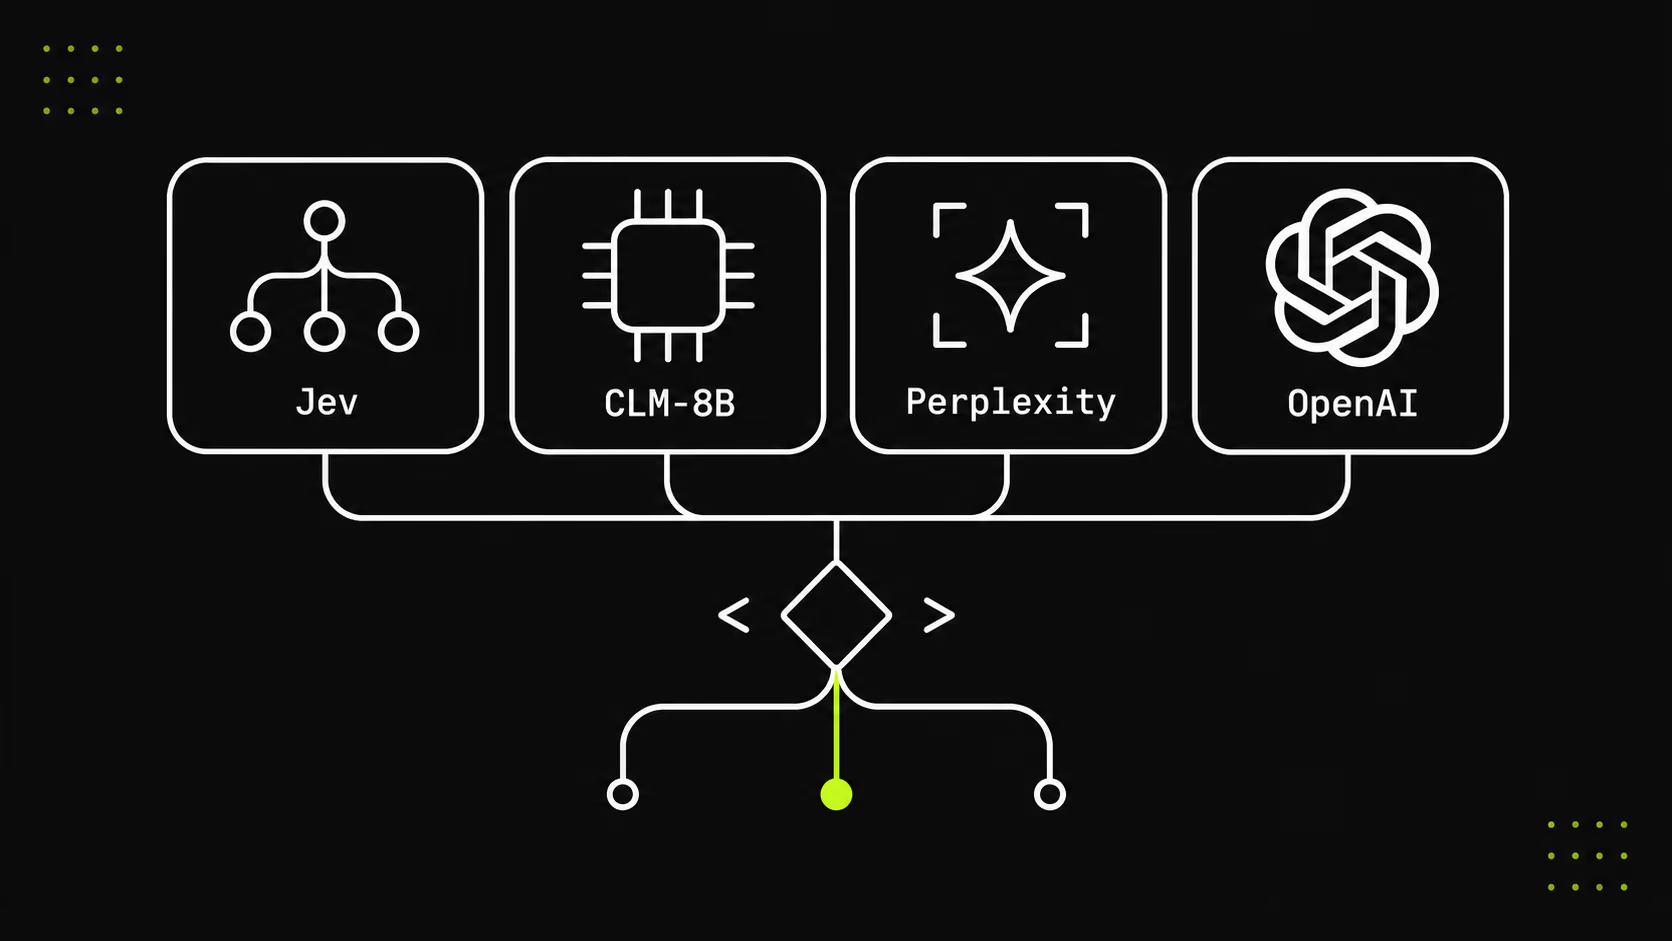
Al 4 novembre 2026 i decision model che puoi usare davvero sono quattro: Jev di TypeSafe (solo API, 0,042 $ per milione di token in ingresso, Jev 1.14 predefinito, ancora in early access), la OpenAI Decisions API (disponibile per tutti dal 22 ottobre, con GPT-6 Luna, 0,10 $ per milione di token in ingresso e fino a 400 domande per richiesta), pplx-decider di Perplexity (API da 0,02 $ per milione di token con la v1.2 da 27B, 0,01 $ con la Flash da 4B, e pesi aperti) e CLM-8B di Stanford e NVIDIA (open source, gira sulla tua GPU, nessun canone). In tutti e quattro l'output è gratuito. La scelta dipende soprattutto da dove devono stare i dati e da quanto contesto ti serve.
Un decision model è un modello che non scrive testo: riceve uno stato (un ticket, una mail, un ordine, lo schermo di un agente) e delle domande con risposte già definite, e restituisce la risposta più probabile con una probabilità accanto. È la categoria che a settembre ha aperto Jev e che in poche settimane si è riempita di alternative.
Ho già scritto due guide dedicate: una su come funziona Jev di TypeSafe e come si usa nel codice e una su CLM-8B, il decision model open source di Stanford e NVIDIA. Qui non ripeto i tutorial: metto i quattro modelli decisionali AI uno accanto all'altro, con i numeri che ho ricontrollato oggi sulle documentazioni ufficiali, e ti dico quale sceglierei caso per caso.
Decision model: la tabella di confronto al 4 novembre 2026
Questi sono i dati pubblicati dai produttori. Dove la documentazione non dice nulla, lo scrivo invece di riempire la casella a occhio.
| Criterio | Jev (TypeSafe) | OpenAI Decisions API | pplx-decider (Perplexity) | CLM-8B (Stanford e NVIDIA) |
|---|---|---|---|---|
| Come si usa | Solo API | Solo API | API oppure pesi aperti | Solo sul tuo server |
| Modello | Jev 1.14 (predefinito dal 14 ottobre) | GPT-6 Luna, unico supportato | v1.2 da 27B e Flash v1.2 da 4B | Qwen3-8B congelato più due teste |
| Prezzo input | 0,042 $ per milione di token | 0,10 $ per milione di token | 0,02 $ (27B) e 0,01 $ (Flash) per milione di token | Nessun canone, paghi l'hardware |
| Output | Gratuito | Gratuito | Gratuito | Gratuito |
| Domande per richiesta | Nessun limite separato, conta il contesto | Da 1 a 400 | Da 1 a 128 | Non indicato |
| Contesto | 64k per richiesta, 262k con intestazione apposita | Non indicato, con moltiplicatori per input lunghi | Sotto 256K token | 2.048 token di default, configurabile |
| Immagini | Sì, ma non pronte per la produzione | Sì | Sì (PNG, JPEG, WebP) | No, solo testo |
| Tipi di domanda | Choice, Score, Noul (e Box in prova) | choice, score, predicate | choice, score, noul | Choice, Score, Noul e Rank |
| Dove girano i dati | Stati Uniti | Stati Uniti o Europa | API: non indicato; pesi: dove vuoi tu | Sul tuo server |
| Stato | Early access | Disponibile per tutti dal 22 ottobre | API attiva, stato beta o GA non dichiarato | Release di ricerca, Apache 2.0 |
Tre cose saltano all'occhio. Il più economico via API oggi è pplx-decider, non Jev. L'unico con l'elaborazione dei dati in Europa dichiarata è OpenAI. E l'unico che non manda nulla a nessuno, a meno di scaricare i pesi di Perplexity, è CLM-8B.
Jev di TypeSafe: il riferimento della categoria
Jev è il System One model con cui TypeSafe AI ha aperto la categoria il 15 settembre 2026. Dal 14 ottobre la versione predefinita è Jev 1.14: sia jev-latest sia jev-preview puntano a jev-1.14.0, e il prezzo è rimasto lo stesso, 0,042 $ per milione di token in ingresso con output gratuito.
- Punto forte: l'ecosistema. SDK ufficiali per Python e TypeScript con i tipi inferiti dalle domande, una skill per gli agenti di coding e un endpoint, /v1/systemone, che è diventato quasi uno standard: lo riprendono CLM-8B e Ollama.
- Contesto: 64k token per richiesta e 32k per stato più la domanda più lunga. Con l'intestazione TypeSafe-Danger-Zone-Long-Context salgono a 262k, allo stesso prezzo ma con risposte più lente e meno precise.
- Limite principale: i dati vanno negli Stati Uniti e il servizio è ancora in early access. Immagini e domande Box esistono, ma TypeSafe stessa scrive che non sono pronte per la produzione.
Tutti i dettagli su primitive, soglie di confidenza e pattern d'uso li trovi nella guida completa a Jev.
OpenAI Decisions API: la scelta per chi ha i dati in Europa
La OpenAI Decisions API è un endpoint dedicato, POST /v1/decisions, che oggi supporta un solo modello: GPT-6 Luna. È partita in beta pubblica il 6 ottobre ed è disponibile per tutti dal 22 ottobre 2026.
- Prezzo: 0,10 $ per milione di token in ingresso non in cache, output non fatturato. Il prefisso ripetuto dell'input ha tariffe scontate in lettura dalla cache. Attenzione ai sovrapprezzi per l'elaborazione regionale e ai moltiplicatori per gli input lunghi, che la documentazione cita senza riportare i valori.
- Volume: da 1 a 400 domande per richiesta, il doppio delle 200 ammesse durante la beta.
- Tipi di domanda: choice, score (da 2 a 10 livelli) e predicate, che è l'equivalente del Noul di Jev. Nomi simili non vogliono dire compatibilità: per passare da Jev a OpenAI riscrivi il modulo che chiama il fornitore.
- Immagini: sì, anche dentro le istruzioni delle singole domande.
- Dati: elaborazione regionale negli Stati Uniti o in Europa (Spazio economico europeo più Svizzera), con Zero Data Retention per i clienti idonei.
Costa più del doppio di Jev e cinque volte pplx-decider. Il motivo per sceglierla è quasi sempre lo stesso: hai già l'account OpenAI, ti serve l'elaborazione in Europa e vuoi un solo fornitore da mettere nel registro dei trattamenti. Se stai valutando anche gli agenti di OpenAI, ho analizzato costi e casi d'uso della OpenAI Agents API.
pplx-decider di Perplexity: il più economico, con pesi aperti
pplx-decider è il decision model di Perplexity, documentato sulle sue pagine ufficiali: la Decisions API di Perplexity risponde su POST /v1/decisions con due modelli.
- pplx-decider-v1.2 (alias pplx-decider-latest): 27 miliardi di parametri, 0,02 $ per milione di token in ingresso.
- pplx-decider-flash-v1.2 (alias pplx-decider-flash-latest): 4 miliardi di parametri, 0,01 $ per milione di token in ingresso.
La storia è rapida. Il primo modello, pplx-decider-v1-27b, è partito a 0,04 $; il 6 ottobre Perplexity ha annunciato la v1.1 a metà prezzo e nel changelog del 19 ottobre la v1.2 e la Flash. Chi chiama ancora i nomi vecchi viene instradato sulla v1.2 e paga la sua tariffa.
Limiti e caratteristiche dell'API
- Domande: da 1 a 128 per richiesta, fino a 255 opzioni per una choice, fino a 10 livelli per uno score.
- Contesto: sotto 256K token per stato, immagini e singola domanda.
- Immagini: PNG, JPEG e WebP come data URL, fino a 8 per domanda. Gli URL http vengono rifiutati.
- Rate limit: 10 richieste al secondo per organizzazione, condivise tra i due modelli.
- SDK: i pacchetti ufficiali Perplexity per Python e TypeScript, oppure qualunque client HTTP.
Pesi aperti e uso in locale
Perplexity presenta la v1.2 come disponibile sia via API sia con pesi aperti. Le schede su Hugging Face riportano la licenza Apache 2.0, ma indicano anche che per scaricarli serve un token con accesso: controlla questo passaggio prima di contarci. Per il 27B servono circa 52 GiB di VRAM solo per i pesi in BF16, quindi una GPU da data center, non una scheda da ufficio.
La Flash è un'altra storia. Con l'app Decider for Mac gira su qualunque Mac con chip M1 o successivo, macOS 13 e 16 GB di memoria, senza chiave API: espone in locale la stessa richiesta della versione hosted. Esiste anche in Ollama, che ha aggiunto pplx-decider con la versione 0.40.7 sull'endpoint /v1/systemone.
Le cautele
- La documentazione non dice dove vengono elaborati i dati dell'API, né se il servizio sia in beta o in disponibilità generale. Prima di inviare dati personali chiedilo.
- I benchmark sono di Perplexity. Sulla scheda della v1.1 dichiara 61,56 nel Decision Index contro 57,9 di Jev, ma è un confronto fatto dal produttore e precedente a Jev 1.14.
- La stessa scheda della Flash avverte che raggruppare molte domande in una richiesta può peggiorare i risultati, e consiglia una domanda per richiesta. È l'opposto del pattern che conviene con Jev: se cambi fornitore, rifai i test.
CLM-8B: il decision model che non esce dal tuo server
CLM-8B è il Contrastive Language Model rilasciato il 23 settembre 2026 da ricercatori di Stanford e NVIDIA. Codice e pesi sono Apache 2.0, l'API è compatibile con quella di Jev e il server espone anche un endpoint di ranking.
- Costo: nessun canone. Ti serve un server Linux con una GPU NVIDIA, perché l'encoder Qwen3-8B gira con vLLM.
- Velocità: nei test degli autori è più veloce di Jev, fino a 9 volte nel caso migliore, grazie alla cache dei vettori delle azioni.
- Precisione: sul tool calling resta indietro, 95,2% contro 99,2% di Jev nei numeri degli autori.
- Contesto: con la configurazione di default gli stati oltre 2.048 token vengono troncati. Si può alzare, con più memoria GPU.
- Solo testo: la versione multimodale, CLM-35B, è annunciata ma al 4 novembre non è ancora uscita.
Installazione in cinque passi, benchmark completi e limiti sono nella guida a CLM-8B.
Quanto costano sullo stesso volume
Ti faccio un conto semplice, solo sui token in ingresso: 100.000 richieste da 1.000 token ciascuna, cioè 100 milioni di token, con i listini ufficiali in dollari.
| Decision model | Costo su 100 milioni di token in ingresso |
|---|---|
| pplx-decider-flash-v1.2 (API) | 1 $ |
| pplx-decider-v1.2 (API) | 2 $ |
| Jev 1.14 | 4,20 $ |
| OpenAI Decisions API | 10 $, più eventuali sovrapprezzi regionali |
| CLM-8B o pesi Perplexity in locale | 0 $ di API, ma GPU, energia e manutenzione a carico tuo |
La lezione è che a questi prezzi la differenza tra un fornitore e l'altro è di pochi dollari. Quello che pesa davvero è altro: quante decisioni sbagliate finiscono a una persona da ricontrollare, quanto lavoro ti costa l'integrazione e se puoi mandare quei dati fuori dall'azienda. Se ti interessa il tema dei costi per token sui modelli generativi, l'ho trattato nella guida al prompt caching su GPT-6, Claude e Gemini.
Quale decision model scegliere: la mia regola pratica
Quando progetto un'automazione con l'AI per un'azienda, parto dal vincolo più rigido, non dal prezzo. Ecco come ragionerei oggi.
| Situazione | Cosa proverei per primo |
|---|---|
| Dati personali di clienti europei, nessuna GPU in casa | OpenAI Decisions API con elaborazione in Europa |
| I dati non devono lasciare l'azienda | CLM-8B su una tua GPU, oppure pplx-decider Flash in locale |
| Massimo volume al minimo costo, dati non sensibili | pplx-decider via API |
| Tool calling dove sbagliare costa caro | Jev, con una soglia di confidenza e un fallback |
| Decisioni su foto o documenti scansionati | OpenAI Decisions API o pplx-decider |
| Prototipo veloce su un Mac | Decider for Mac o Ollama |
| Serve spiegare il perché della decisione | Nessun decision model: un LLM con ragionamento |
In tutti i casi vale la stessa regola: il decision model gestisce i casi chiari sopra una soglia di confidenza, il resto passa a un LLM o a una persona. Le soglie non si trasferiscono da un fornitore all'altro, perché ogni modello è calibrato a modo suo.
Come confrontarli sui tuoi dati
I benchmark dei produttori non scelgono il modello per te: ognuno misura su compiti suoi, spesso contro versioni ormai superate dei concorrenti. Il confronto che conta lo fai tu, in poche ore.
- Raccogli qualche centinaio di casi reali con la risposta giusta assegnata da chi conosce il lavoro, compresi quelli ambigui e quelli in cui nessuna opzione va bene.
- Scrivi una sola volta domande e opzioni, in un modulo separato dal fornitore, così cambi provider senza riscrivere il flusso.
- Fai girare due o tre candidati in parallelo al sistema attuale, senza che comandino le azioni.
- Misura errori, latenza dalla tua regione e costo complessivo, compresi i casi passati a revisione.
- Fissa la versione (per esempio jev-1.14.0 o pplx-decider-v1.2 invece degli alias latest) e salva nel log modello, probabilità e confidenza.
Questo è anche il modo in cui scrivo le integrazioni nelle web app e nei gestionali che sviluppo: soglie e fallback stanno nel codice, il fornitore è un dettaglio sostituibile.
Privacy e GDPR: dove finiscono i dati
Per un'azienda italiana questo è spesso il criterio che decide. In sintesi:
- Jev: servizio basato negli Stati Uniti. TypeSafe pubblica un accordo sul trattamento dei dati con le clausole contrattuali standard, ma non indica dove sono conservati i dati.
- OpenAI Decisions API: elaborazione in Europa disponibile, con Zero Data Retention per i clienti idonei.
- pplx-decider via API: la documentazione della Decisions API non indica la residenza dei dati. Va chiesto prima di firmare.
- CLM-8B e pesi Perplexity in locale: i dati non escono dal tuo server o dal tuo Mac, e la valutazione GDPR si semplifica molto.
Con il decreto sull'intelligenza artificiale, tenere traccia delle decisioni automatiche conta anche in caso di contestazioni: un decision model che restituisce una probabilità è più facile da documentare di un testo libero.
Leggi anche
- Jev AI di TypeSafe: cos'è, Jev 1.14, prezzi e come si usa
- CLM-8B, il decision model di NVIDIA: cos'è e come usarlo
- OpenAI Agents API: cos'è, quanto costa e quando usarla
- Prompt caching: quanto si risparmia su GPT-6, Claude e Gemini
- Database vettoriale: quale scegliere e quando evitarlo
Conclusione: il decision model giusto dipende dai dati, non dal listino
Due mesi fa un decision model era la scommessa di una sola startup. Al 4 novembre 2026 hai un servizio di riferimento (Jev), un'opzione con i dati in Europa (OpenAI Decisions API), un'API più economica con pesi aperti (pplx-decider) e un modello open source da far girare in casa (CLM-8B). I prezzi sono così bassi che raramente saranno loro a decidere.
Decidono il luogo dei dati, il contesto che ti serve, la presenza di immagini e l'accuratezza sul tuo caso. Il mio consiglio: scegli due candidati dalla tabella qui sopra, mettili in parallelo per una settimana sui tuoi dati e tieni il codice indipendente dal fornitore. Se vuoi capire quale decision model ha senso nel tuo flusso, scrivimi: rispondo io.