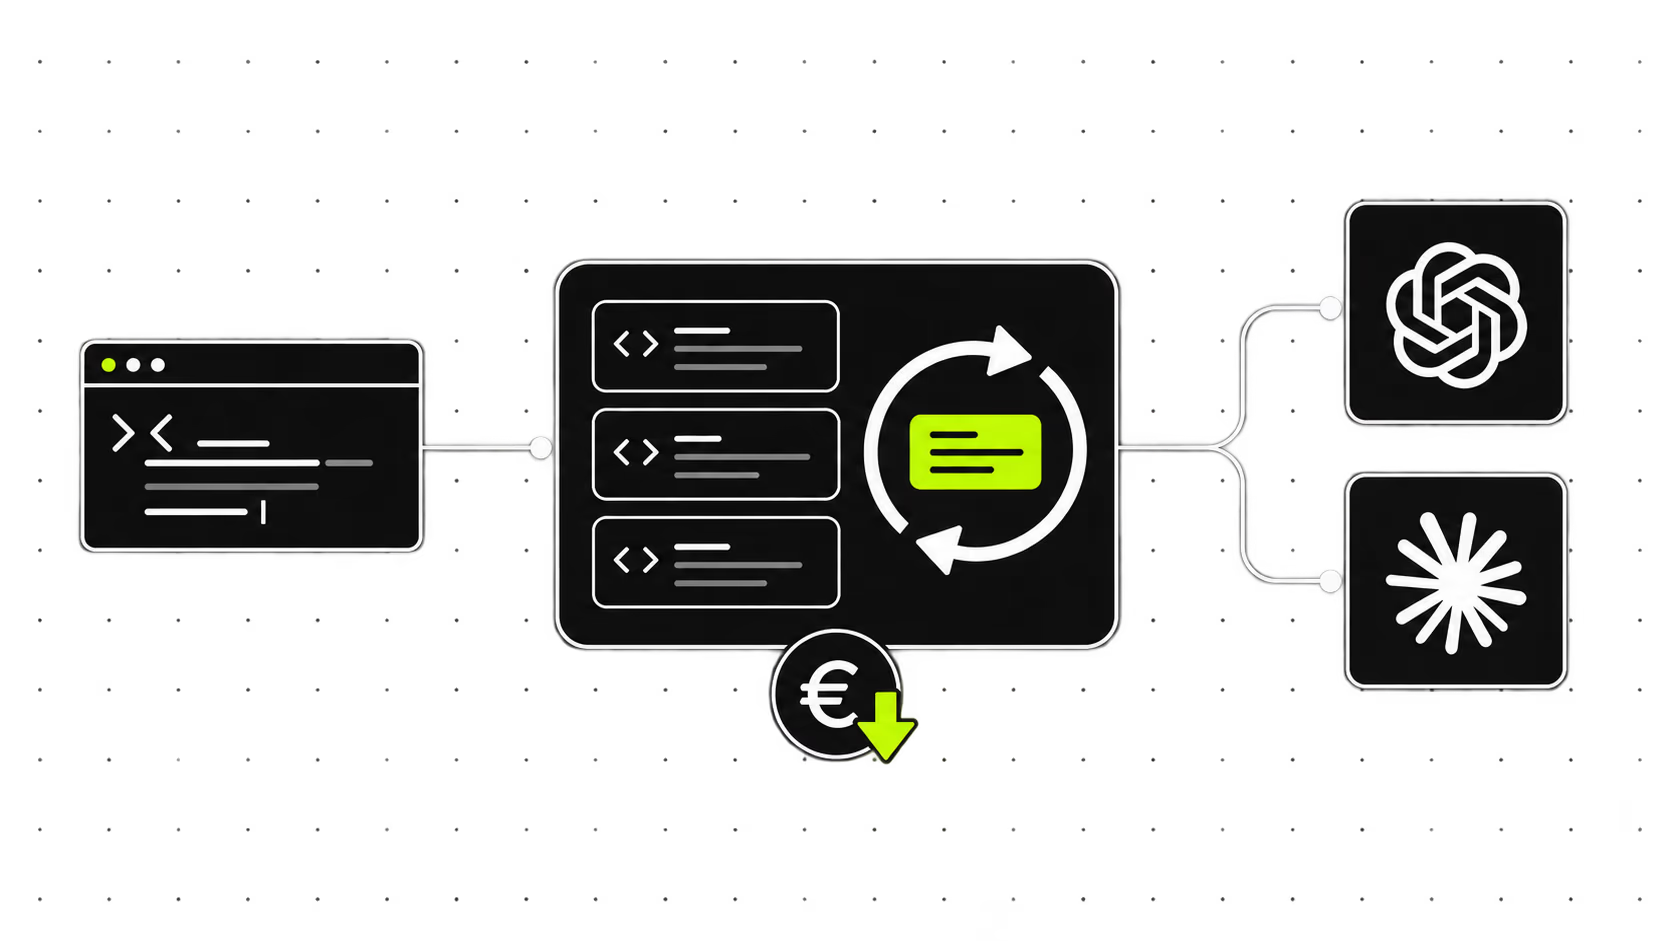
Prompt caching este setarea pe care o gasesc cel mai des lipsa cand deschid codul unui agent AI care "costa prea mult". Modelul e bun, prompturile sunt bune, dar fiecare apel reproceseaza de la zero aceleasi instructiuni, aceleasi definitii de unelte si acelasi istoric. Si le platesti de fiecare data la pret intreg.
Pe 22 septembrie 2026 OpenAI a refacut prompt caching pentru familia GPT-6, iar Anthropic a coborat citirea din cache pe Claude Opus 5.5 la 0,20 $ pe milion de tokeni. In Romania aproape nimeni nu a scris despre asta in limba romana, desi "claude api" si "openai api" se cauta constant. Mai jos ai cum functioneaza pe GPT-6, Claude si Gemini, cu cifrele oficiale, cod, costul in lei si greseala care strica cache-ul in noua cazuri din zece.
Ce este prompt caching, pe scurt
Cand un model citeste inputul, calculeaza pentru fiecare token niste stari intermediare (cache-ul KV, adica chei si valori). Prompt caching pastreaza aceasta munca pentru partea de inceput a promptului care nu se schimba, numita prefix. Daca urmatoarea cerere incepe cu exact acelasi prefix, modelul continua de acolo in loc sa recalculeze totul.
- Cost: tokenii cititi din cache costa o fractiune din pretul normal, de regula o zecime sau mai putin.
- Viteza: timpul pana la primul token al raspunsului scade, mai ales cu contexte lungi.
- Raspunsul nu se schimba: modelul genereaza output-ul la fel ca fara cache. Nu este un cache al raspunsurilor, ci al muncii facute pe input.
Regula cea mai importanta: cache-ul functioneaza doar pe prefixul identic. Un singur caracter diferit la inceput si tot ce urmeaza se recalculeaza.
Prompt caching comparat: OpenAI, Claude si Gemini
| Ce compari | OpenAI (GPT-5.6 si GPT-6) | Anthropic (Claude) | Google (Gemini) |
|---|---|---|---|
| Activ implicit | Da, mod implicit | Nu, se activeaza cu cache_control |
Da, cache implicit de la modelele 2.5 in sus |
| Minim de tokeni | 1.024 tokeni vizibili | 512 pe Opus 5.5, 1.024 pe Sonnet 5, 4.096 pe Haiku 4.5 | 4.096 pe Gemini 3.8 Flash si 3.1 Pro Preview |
| Durata cache | Cel putin 30 de minute de la ultima folosire | 5 minute implicit, 1 ora contra cost | Implicit fara garantie; explicit cu TTL implicit de 1 ora |
| Cost scriere | 1,25 x inputul normal | 1,25 x (5 minute) sau 2 x (1 ora) | Explicit: tokeni in cache plus stocare pe durata aleasa |
| Cost citire | 0,1 x inputul normal | 0,1 x; 0,05 x pe Opus 5.5 | Tarif redus pe tokenii din cache |
| Control manual | Breakpoint-uri explicite, pana la 4 scrieri pe cerere | Pana la 4 breakpoint-uri | Obiecte cache create prin API |
Diferenta practica: la OpenAI si Gemini cache-ul implicit porneste singur, la Claude nu. Daca folosesti Claude API si nu ai scris niciodata cache_control in cod, cel mai probabil platesti totul la pret intreg.
Cat economisesti: un calcul pe Claude Opus 5.5, in dolari si in lei
Iau un caz tipic: un agent cu system prompt si definitii de unelte de 20.000 de tokeni, care face 50 de apeluri intr-o sesiune, fiecare la mai putin de 5 minute de cel anterior. Preturile oficiale Opus 5.5: 4 $ pe milion la input, 5 $ pentru scrierea in cache pe 5 minute, 0,20 $ pentru citire.
- Fara prompt caching: 50 de apeluri x 20.000 de tokeni = 1 milion de tokeni, adica 4 $ (circa 18 lei) doar pentru prefixul repetat.
- Cu prompt caching: o scriere de 20.000 de tokeni costa 0,10 $, apoi 49 de citiri pentru 980.000 de tokeni costa circa 0,20 $. Total circa 0,30 $ (aproximativ 1,4 lei).
Pe prefix treci de la circa 18 lei la sub 1,5 lei pe sesiune, o economie de aproximativ 92%. Conversia foloseste un curs de circa 4,58 lei pentru un dolar, fara TVA. Restul cererii (mesajul nou si output-ul) se plateste ca de obicei.
Pe GPT-6 logica e aceeasi, cu alti multiplicatori. Documentatia OpenAI da exemplul acesta: un prefix scris o data si citit de noua ori costa 2,15 ori pretul lui normal, fata de 10 ori fara cache. Comparatia preturilor de baza intre modele o gasesti in articolul despre GPT-6 Sol, Astra si Luna.
Cum activezi prompt caching in Claude API
Cea mai simpla varianta este cache-ul automat: un singur camp cache_control la nivelul principal al cererii. Sistemul pune punctul de cache pe ultimul bloc eligibil si il muta inainte pe masura ce conversatia creste.
import anthropic

client = anthropic.Anthropic()

response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=1024,
    cache_control={"type": "ephemeral"},
    system="Instructiunile stabile ale agentului...",
    messages=[{"role": "user", "content": "Intrebarea utilizatorului"}],
)

print(response.usage)
Cand partile promptului se schimba in ritmuri diferite, folosesc breakpoint-uri explicite (maxim 4): unul dupa unelte, unul dupa instructiuni, unul dupa documentele de context. Ordinea in care Claude construieste cache-ul este mereu unelte, apoi system, apoi mesaje. Daca schimbi definitia unei unelte, tot ce urmeaza se invalideaza.
Pentru durata de 1 ora adaugi "ttl": "1h" in cache_control. Merita cand intre cereri trec mai mult de 5 minute, dar mai putin de o ora, de exemplu un utilizator care raspunde mai incet in chat.
Prompt caching in OpenAI API cu GPT-6
Pe GPT-6 cache-ul implicit este deja activ si acum aplica reducerea la prefixele refolosite in 30 de minute. Noutatile din 22 septembrie iti dau mai mult control:
- Breakpoint-uri explicite: cu
prompt_cache_options.modepeexplicitdecizi tu unde se termina partea salvata, marcand blocul cuprompt_cache_breakpoint. Ce vine dupa ultimul breakpoint nu se scrie in cache si nu platesti suprataxa de scriere. - Schimbi nivelul de rationament fara sa pierzi cache-ul: in loc sa modifici
reasoning.effort, adaugi la final un elementconfiguration_update. - Preincalzire: cu
prompt_cache_options.prewarmpetrueprefixul se pregateste inainte sa vina utilizatorul, fara output. - Panou si diagnoza: platforma iti arata rata de reutilizare si, la un cache ratat, motivul (de exemplu, unelte schimbate).
Parametrii mai vechi prompt_cache_key si prompt_cache_retention, pe care ii gasesti in multe tutoriale, conteaza pentru modelele de dinainte de GPT-5.6. Pe GPT-6 cheia serveste doar daca vrei evidenta separata pe clienti, iar durata se seteaza cu prompt_cache_options.ttl. In raspuns verific mereu cached_tokens si cache_write_tokens.
Gemini: cache implicit si explicit
Pe Gemini cache-ul implicit e activ, dar fara garantie de economie. Minimul pe modelele recente, ca Gemini 3.8 Flash, este de 4.096 de tokeni, deci prompturile scurte raman pe dinafara.
Pentru garantie ai nevoie de cache-ul explicit, in beta si disponibil doar prin API-ul generateContent. Creezi un obiect cu client.caches.create, ii dai un TTL (implicit 1 ora) si il refolosesti in cererile urmatoare. Platesti si stocarea pe durata aleasa, asa ca merita doar pe contexte mari folosite des: un manual, un repository, un video interogat de mai multe ori.
Greseala care strica prompt caching cel mai des
Cazul pe care il vad cel mai des: o data, o ora sau un nume de utilizator puse la inceputul system promptului. "Azi este 25 septembrie, ora 10:32, utilizatorul se numeste Andrei..." si dedesubt 15.000 de tokeni de instructiuni fixe. Prefixul se schimba la fiecare apel, cache-ul nu se citeste niciodata, iar pe Claude platesti in plus si scrierea de fiecare data.
- Intai ce e stabil, apoi ce variaza: unelte si instructiuni fixe sus, date si detalii despre utilizator jos.
- Nu schimba uneltele in mijlocul sesiunii: daca agentul trebuie sa foloseasca mai putine unelte, le dezactivez (pe OpenAI cu
allowed_toolssautool_choice) in loc sa le scot din lista. - Atentie la memorie si rezumate: un nod care rescrie istoricul la fiecare pas schimba prefixul. In fluxurile n8n cu agent AI si memorie in baza de date, asta verific primul.
- Chei JSON in ordine stabila: unele limbaje reordoneaza cheile, iar o ordine diferita inseamna alt prefix.
- Sub prag nu se intampla nimic: pe Claude un prompt prea scurt nu da eroare, pur si simplu nu intra in cache. Daca ambele campuri de cache sunt zero, de obicei asta e motivul.
De ce ti se termina fereastra de 5 ore in Claude Code
Pe forumuri apare des aceeasi plangere: limita de utilizare din Claude Code se consuma mult mai repede decat te astepti. O parte din explicatie este tot cache-ul. Cand schimbi modelul in mijlocul sesiunii, cand contextul se rescrie sau cand revii dupa o pauza lunga, prefixul trebuie recalculat, iar asta consuma cota. Cum tii sesiunile eficiente am explicat in ghidul de optimizare Claude Code, iar costurile abonamentelor le gasesti in cat costa Claude in 2026.
Cum verific ca prompt caching functioneaza
Nu ma bazez pe setare, ma uit la cifrele din raspuns. Pe Claude campurile sunt cache_creation_input_tokens si cache_read_input_tokens: la primul apel creste primul, de la al doilea incolo al doilea. Pe OpenAI urmaresc cached_tokens si rata din panou. Pe Gemini numarul apare in metadatele de utilizare.
O nota pentru firmele din Romania care platesc API-ul pe SRL: facturile OpenAI, Anthropic sau Google vin de la furnizori straini, nu trec prin e-Factura, iar TVA-ul se trateaza de regula prin taxare inversa. Verifica cu contabilul inainte de un consum mare.
Cand prompt caching nu merita
Nu merita cand prefixul e sub pragul minim si nu are sens sa il lungesti, cand cererile sunt rare (peste 5 minute pauza pe Claude, peste 30 pe GPT-6) sau cand fiecare apel are alt context. In aceste cazuri, cu scrierea in cache platesti doar suprataxa.
Unde rentabilizeaza cel mai mult: agenti cu multe unelte, chatboti cu instructiuni lungi, analize repetate pe aceleasi documente si orice flux cu zeci de apeluri inlantuite. Daca construiesti ceva de genul asta si vrei sa vezi unde pierzi bani, este munca pe care o fac in proiectele de automatizari AI: scrie-mi si iti raspund eu direct.